端侧模型评测该看哪些指标,而不是只看榜单分数
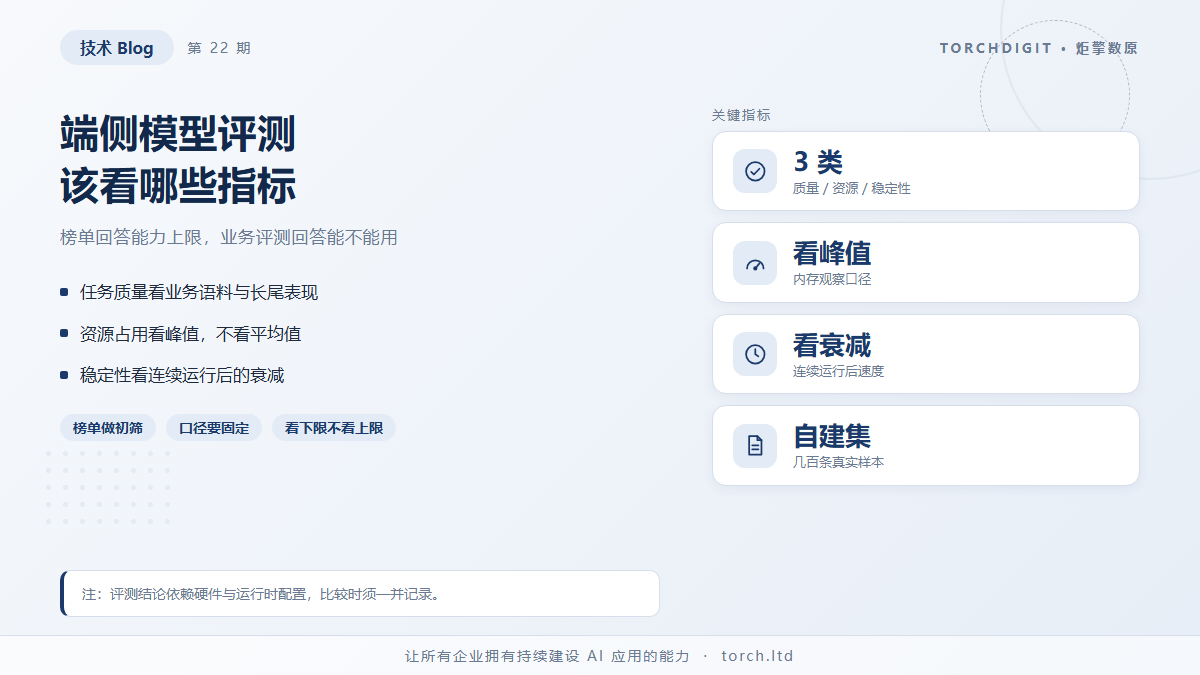
榜单分数回答的是「通用能力有多强」,回答不了「放进这台设备后能不能用」。端侧部署的评测至少要多回答三个问题:在目标硬件上跑得动吗、在业务语料上答得对吗、连续跑一周还稳吗。这三件事在公开榜单里一项都测不到,而它们恰恰决定项目能不能通过验收。
通用榜单衡量的是能力上限,业务评测看的是可用下限
公开榜单的价值在于横向可比。同一套题目、同一套评分规则,不同模型放在一起看,能快速筛掉明显不合适的选项。但它有两个天然限制。
一是题目与业务无关。榜单考的是常识问答、数学推理、代码生成这类通用任务,而企业实际要处理的是单据抽取、工单分类、规程问答。模型在榜单上领先几个百分点,到了具体任务上未必领先,甚至可能因为训练数据分布不同而落后。
二是它只测「答对没有」,不测「代价多大」。同样答对一道题,一个模型花 0.3 秒、占 600MB 内存,另一个花 3 秒、占 1.8GB,在服务器上差别不大,在内存只有几 GB 的工控机上就是能不能装的差别。
所以榜单适合用来做初筛,不适合用来做决策。
三类指标要分开测:任务质量、资源占用、稳定性
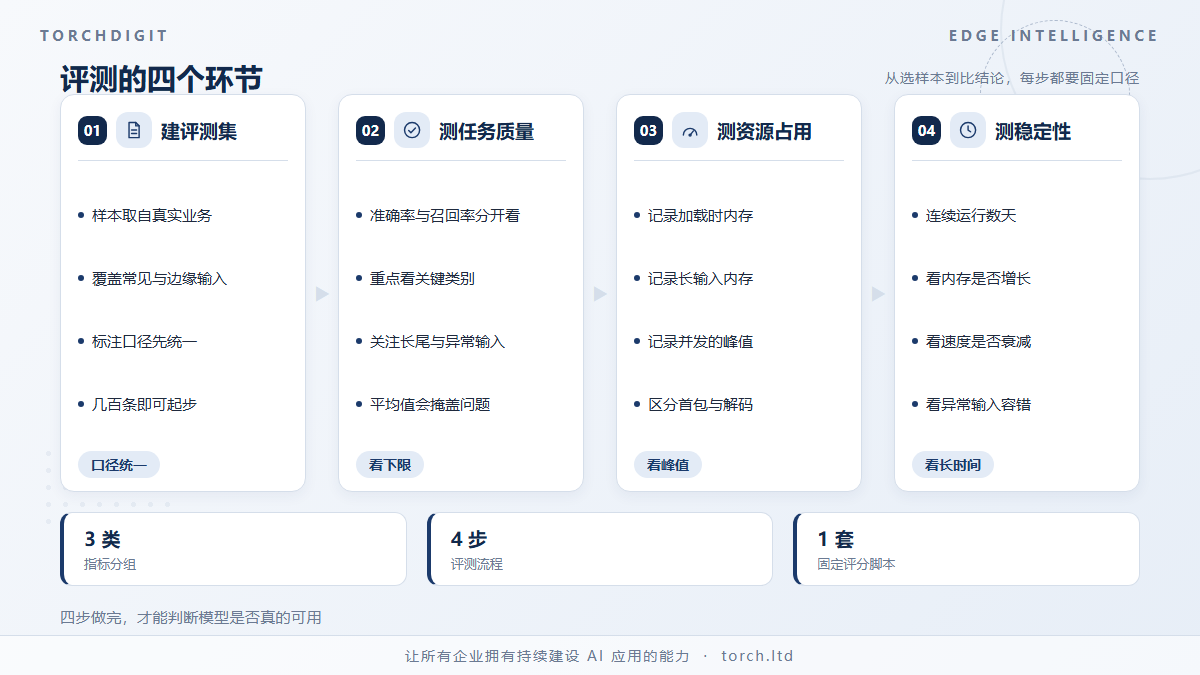
把评测拆成三类,每类有各自的观察对象。
任务质量看业务语料上的实际表现。做法是从真实业务数据里抽一批带标注的样本,覆盖常见输入与边缘输入,分别测准确率与召回率,并且要看长尾表现而不是平均值。平均值好看但关键类别崩掉的模型,在生产环境里风险最高。
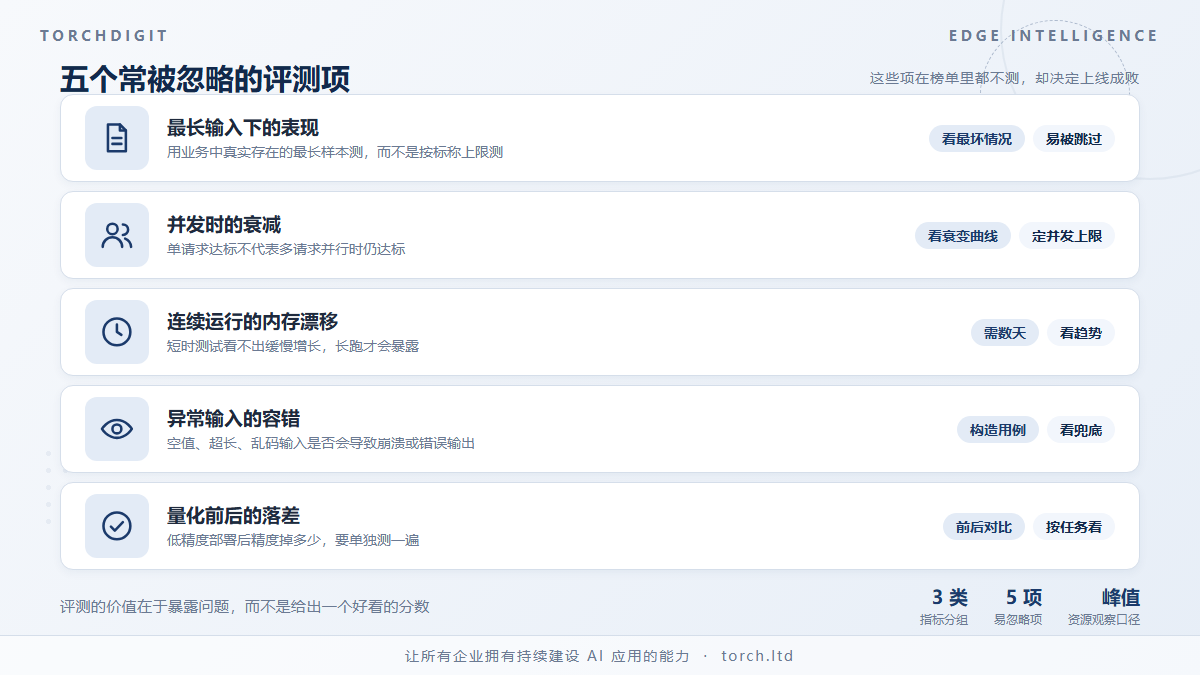
资源占用看峰值而不是均值。要记录加载完成时的内存、长输入下的内存、以及并发请求时的内存峰值。速度方面区分首 token 延迟与解码速度,前者决定体感,后者决定批量任务的排队时间。
稳定性看长时间运行的表现。连续运行数天,观察内存是否缓慢增长、速度是否衰减、异常输入是否会导致进程崩溃。这类问题在短时测试里几乎不会暴露,却是在现场最常出现的问题。
三类指标分开测,好处是能定位问题出在哪一层。速度不达标可能是硬件带宽不够,也可能是算子没走加速路径,还可能是量化后没有用上低精度指令。混在一起测,就只剩下「慢」这一个结论。
评测集要自己建,口径要固定下来
用别人的评测集,只能得到别人的结论。企业应该建自己的评测集,规模不必大,几百条覆盖主要任务形态的样本就够用,关键是三点:样本来自真实业务而非构造、标注口径统一、数据集版本固定。
口径固定尤其重要。如果两次评测用了不同的样本集或不同的打分标准,得到的差值没有意义。建议把评测集与评分脚本一起做版本管理,每次模型迭代都跑同一套,这样纵向对比才成立。横向对比则要确保双方用同一套评测集与同一套硬件配置,否则比的是环境而不是模型。