同等参数量下端侧模型的能力差距从哪来
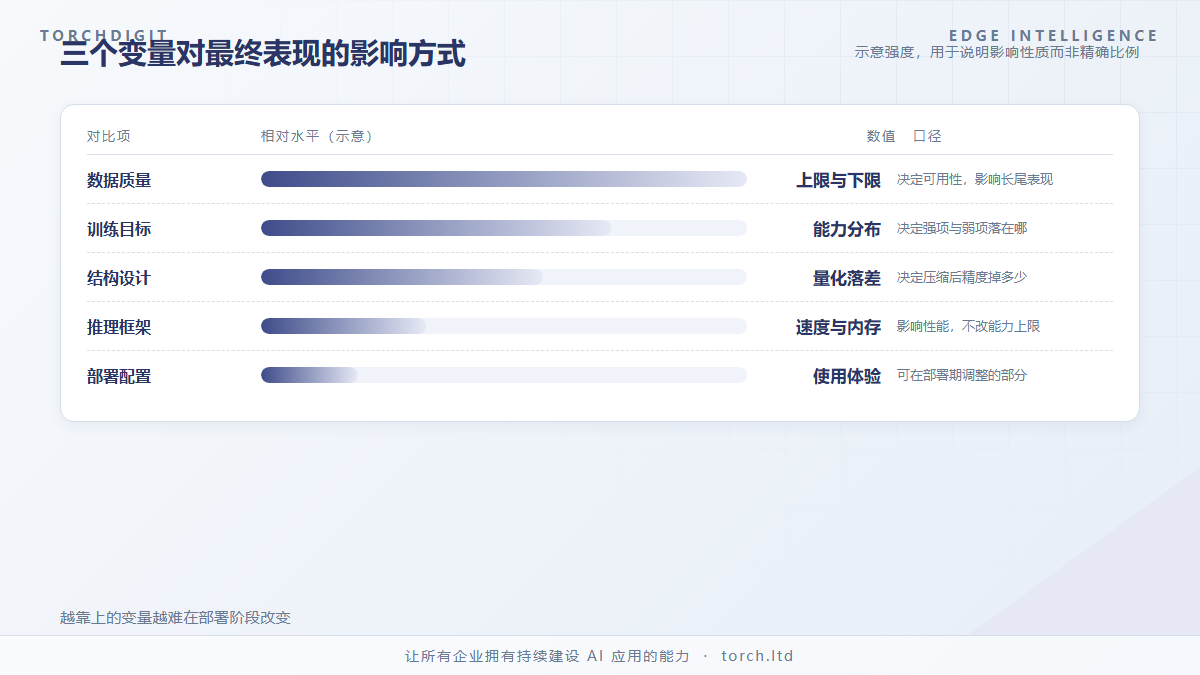
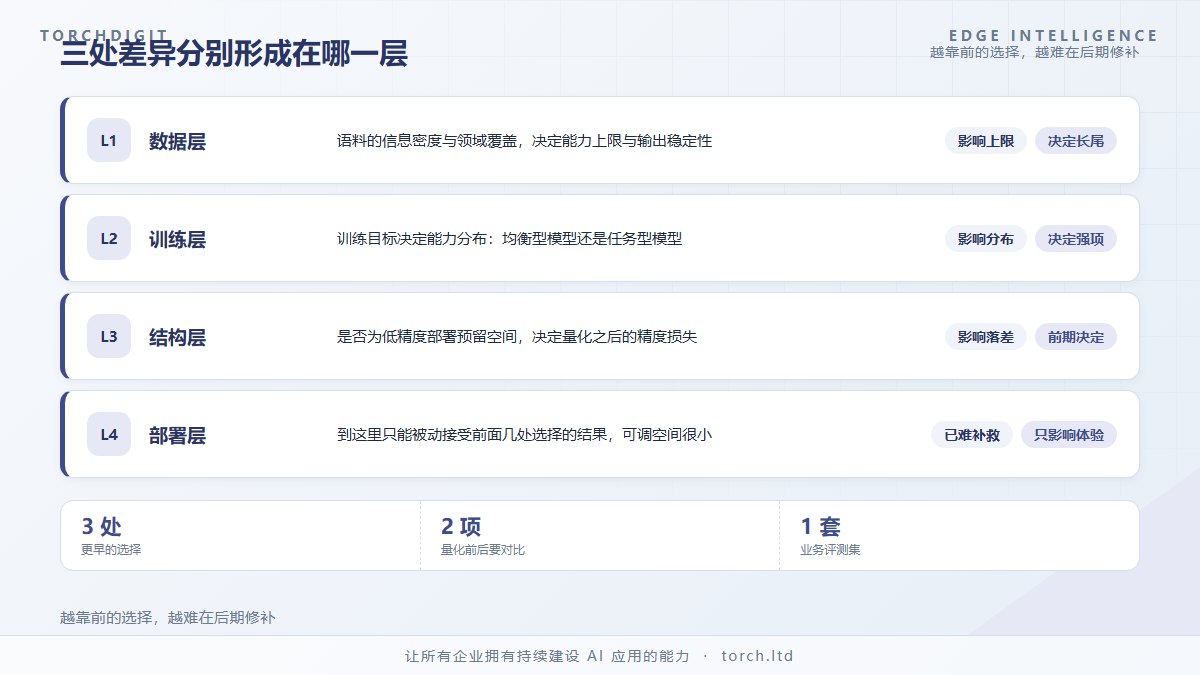
一排模型摆在面前,参数量标注相同,规格表看起来一样,实际使用中的表现却可能相差明显。这种差距不来自参数量,而来自三个更早的环节:喂进去的数据、训练时设定的目标、以及有没有为后续的量化与部署预留结构空间。理解这三处差异,比看参数表更能预判一个端侧模型能不能用。
数据质量是第一个变量
同等参数量下,模型能力的上限由训练数据决定。同样规模的语料,经过去重、质量筛选与领域配比处理之后,单位 token 携带的信息量明显不同。用低质量语料训练的同规格模型,往往在长尾任务上表现吃力——它见过足够多的文本,但没有见过足够多「有用」的文本。
端侧模型的语料构成还有一层特殊要求:需要覆盖企业任务的输入形态。单据、工单、巡检记录、操作规程,这些文本的格式规范性与通用语料差别很大。如果训练语料里这类内容占比过低,模型在真实业务输入上的表现会明显低于通用基准上的得分。
数据质量的影响还有一个隐蔽之处:它决定了模型的「下限」。高质量数据训练出来的模型,在没见过的任务上表现也相对稳定;低质量数据训练出来的模型,方差更大,偶尔出色但不可靠。生产环境更在意下限而不是上限。
训练目标决定能力分布
第二个变量是训练目标。同样的数据、同样的参数量,用不同的训练目标训练,得到的是能力分布不同的模型。
以通用语料上的语言建模为目标,得到的是能力均衡但都不突出的模型。以任务形态为目标——比如把抽取、分类、结构化输出作为训练的一部分——得到的模型在特定任务上表现更好,代价是通用对话能力可能稍弱。
这个取舍没有对错。端侧模型的价值本来就体现在特定任务的可靠表现上,用一部分通用能力换取任务能力,对多数企业场景是划算的。但如果选型时只看通用榜单分数,可能会误判一个任务型模型的真实价值。
还有一种常被忽略的目标设计:输出格式的约束训练。让模型稳定输出符合约定的结构化结果,比让它在自由生成中偶尔生成正确结构更有工程价值,因为下游系统要解析这些输出。
量化友好性要提前设计
第三个变量在模型结构层面。端侧模型最终要经过量化,而不同结构对量化的耐受度差别很大。有些模型在 16 位浮点下表现良好,压到 int4 之后精度掉落明显;有些模型在设计阶段就考虑了低精度需求,量化后损失可控。
造成这种差异的因素包括:激活值分布是否集中、是否存在对精度高度敏感的层、注意力计算中是否使用了数值稳定性较差的实现。这些问题在训练完成之后再修补,成本远高于设计阶段就规避。
因此评估一个端侧模型,除了看量化后的基准分数,还应该看量化前后的精度落差。落差小的模型,在实际部署时更省心——不需要为了保住精度而放弃压缩率。