端侧模型的多后端一致性:同一模型在 CPU 与 NPU 上结果不同怎么办
同一个模型文件,在 CPU 上推理与在 NPU 上推理,输出可能不完全一致。这是数值计算路径不同导致的正常现象,不是模型损坏。问题在于这种差异会影响结果判定,需要在工程上加以控制,而不是期待它不存在。
差异从哪里来
差异的来源主要有三类。
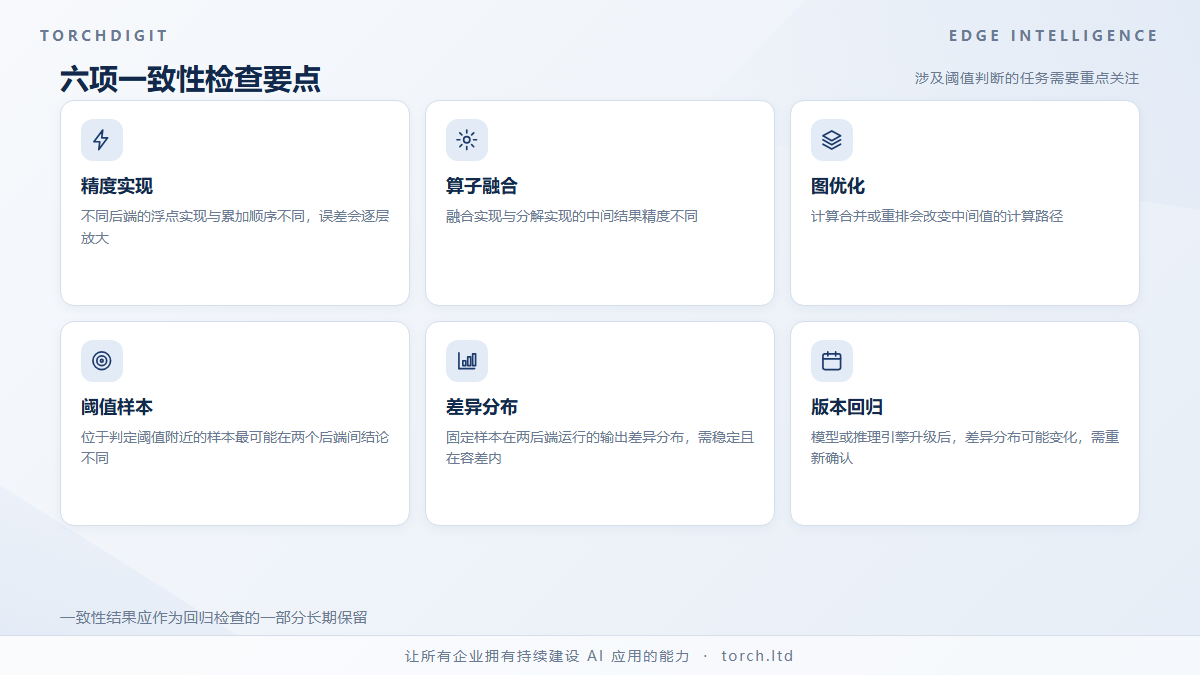
一是精度与累加顺序。不同后端对浮点运算的实现方式不同,矩阵乘法的累加顺序也可能不同,微小误差会逐层放大。量化模型还会引入额外的舍入差异。
二是算子实现差异。同一算子在 NPU 上可能是融合实现,在 CPU 上是分解实现,中间结果的精度与处理方式不同。
三是编译与优化策略。图优化可能合并或重排部分计算,改变了中间值的计算路径。
这些差异通常不大,但会影响对边界条件的判断:一个位于阈值附近的样本,可能在一个后端被判为通过,在另一个后端被判为不通过。
用容差代替精确相等
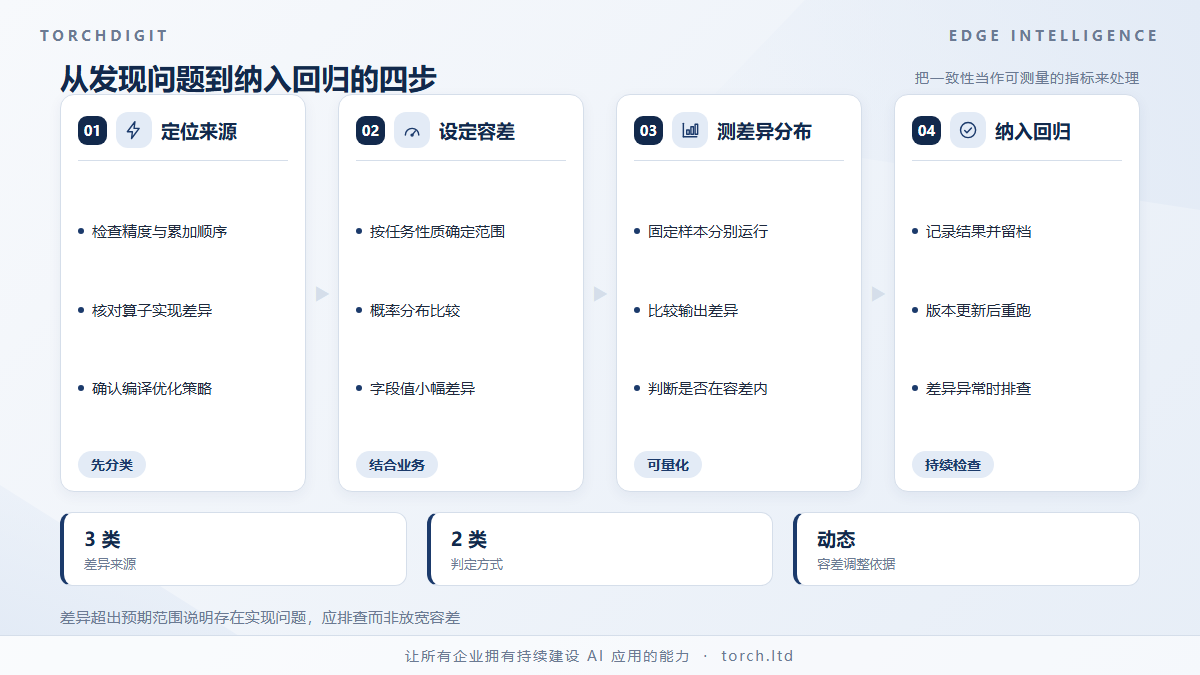
既然差异不可避免,工程上的处理方式是把判定标准从精确相等改为落在容差范围内。
对于分类任务,可以比较输出类别的概率分布,允许一定范围内的偏差。对于抽取任务,可以比较结构化输出的字段值,允许数值型字段有小幅差异。
容差范围需要结合业务确定。影响较小的场景可以放宽,直接影响判定结果的场景需要收紧,并在方案中说明收紧带来的代价。
需要注意的是,容差不是用来掩盖问题。如果两个后端的差异超出预期范围,说明存在配置或实现问题,应当排查而不是调整容差。
一致性要纳入评测
多后端场景下,评测需要覆盖一致性维度,而不只是单后端的准确率。
可行的做法是准备一批固定样本,在两个后端上分别运行,比较输出差异的分布。差异分布稳定且在容差内,说明实现可用;分布出现异常,说明某个后端存在问题。
评测还应当覆盖典型的设备组合。不同厂区的设备型号不同,实际使用的后端可能不止两种,评测应当在主要组合上完成,而不是只测其中一种。
一致性结果需要记录并随版本更新重新执行,作为回归检查的一部分。模型或推理引擎升级后,差异分布可能变化,需要重新确认。