多厂区场景下 AI 统一管理的难点在哪
把 AI 铺到多个厂区,建设期的问题相对集中:设备、网络、部署。真正长期消耗精力的是另一类问题:谁来决定改什么、各厂区数据口径是否一致、总部的统一要求与厂区实际条件冲突时听谁的。这些属于管理问题,但会直接决定系统能不能长期用下去。
权责边界先于技术方案
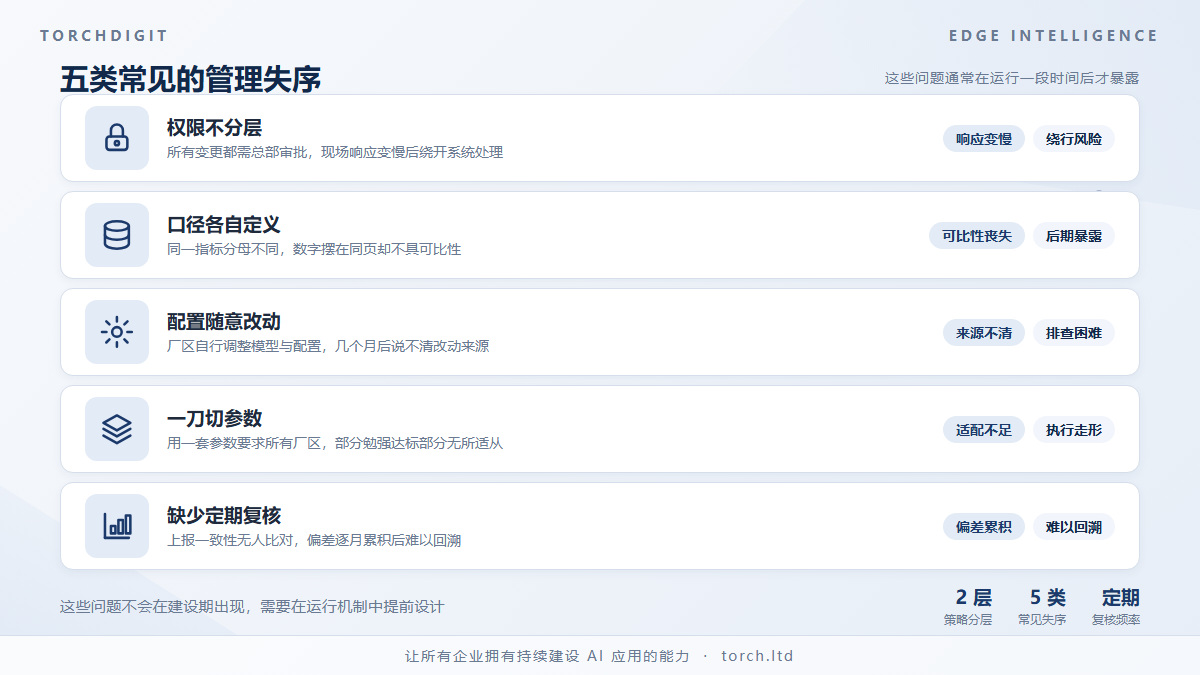
多厂区场景最常见的失序,是权限没有分清。总部能改什么、厂区能改什么,需要在系统上线前明确。
一种情况是总部管得过细,所有配置变更都要审批。结果是厂区遇到小问题也要等待,响应变慢,现场逐渐绕开系统自行处理。另一种情况是放得过松,各厂区自行调整模型与配置,几个月后同一套系统在不同厂区表现差异明显,排查时已经说不清改动来源。
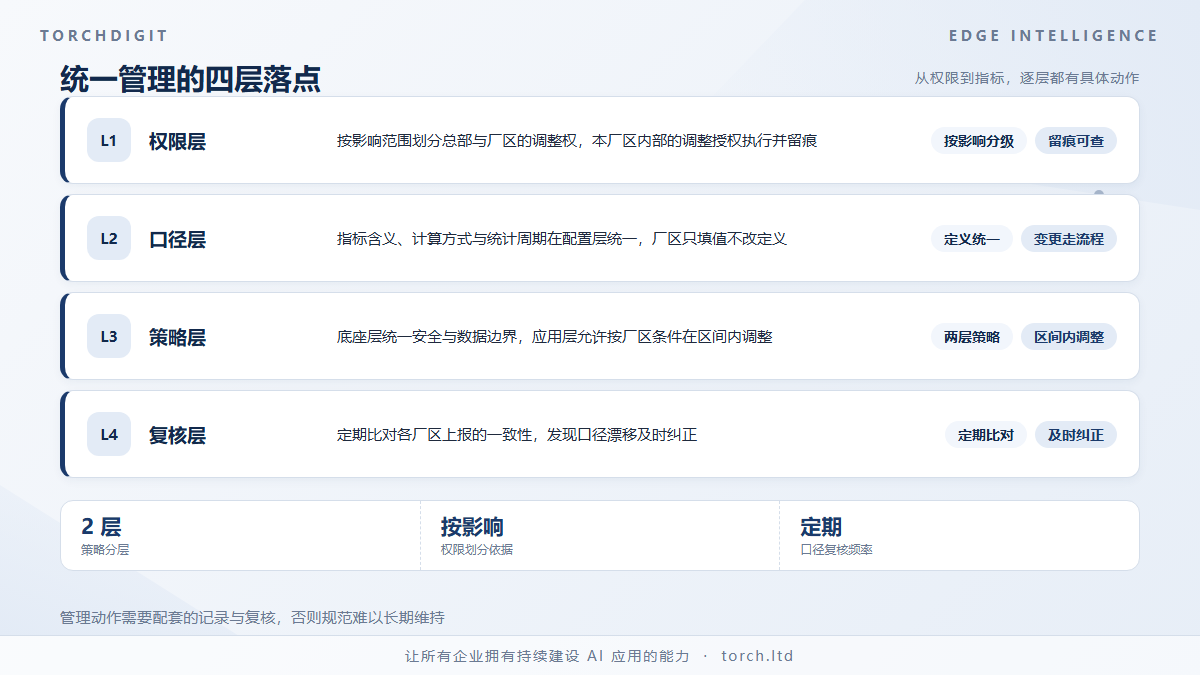
相对可行的划分是按影响范围定。只影响本厂区、不影响对外口径的调整,授权厂区执行并留痕;涉及模型版本、数据上报口径、对外输出的变更,由总部审批。界线写清楚,比事后协调有效。
口径不一致会让汇总失真
总部看到的数据来自各厂区的上报。如果各厂区对同一指标的定义不同,汇总结果就失去意义。
这类问题往往在运行一段时间后才暴露。例如同一个处理量,有的厂区统计全部进入系统的任务,有的只统计成功完成的;同一个异常率,分母的定义不一样。数字摆在同一个页面上,可比性却不存在。
解决办法是把指标定义写进系统,而不是写在文档里。上报字段的含义、计算方式、统计周期,在配置层面统一,厂区只能填值不能改定义。新增指标时走变更流程,而不是各厂区自行扩展。
统一策略与本地差异需要共存
完全统一和完全放开都不合适。厂区之间的工艺、设备年限、人员配置本来就不同,用一套参数要求所有厂区,结果多半是部分厂区勉强达标、部分厂区无所适从。
较为务实的做法是把策略分成两层。底座层统一:安全要求、数据边界、审计留痕这些不因厂区而异。应用层允许差异:模型规格、并发上限、告警阈值可以按厂区条件设置,但取值范围要在总部给定的区间内。
这样既保证了下限,也保留了调整空间。分层方式需要在制度文件中写明,避免执行时两边推诿。