端侧 Agent 与云端 Agent 的分工边界在哪
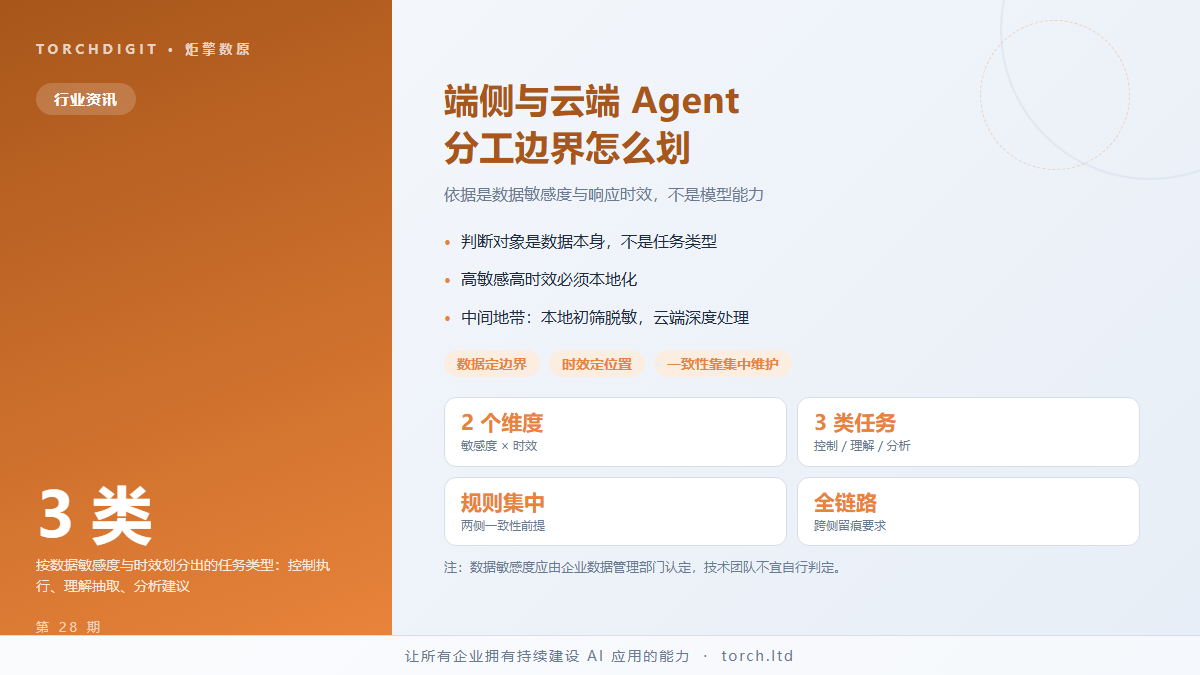
把智能体的能力全放在云端,数据要出域、响应受网络制约;全放在端侧,算力与知识广度又受限。多数企业的实际选择是混合:一部分任务留在本地,一部分交给云端。难点在于这条线怎么划。按经验,划分依据是数据敏感度与响应时效,而不是模型能力强弱。
划分依据是数据敏感度与响应时效
先看数据。任务处理过程中需要读取的数据,如果属于不得出域的范围,那么推理就必须在本地完成。这里要注意的是,判断对象是「数据本身」而不是「任务类型」:同样是一次文档问答,输入的是公开资料还是内部合同,结论完全不同。
再看时效。需要在秒级给出结果、或者现场网络不可靠的任务,适合放在本地。反过来,可以容忍几十秒等待、且需要较强推理能力的任务,交给云端更划算。
把两个维度放在一起,会得到三类任务。高敏感高时效的必须本地化;低敏感低时效的可以全部上云;处在中间的,才是真正需要设计的地方——这类任务通常的解法是本地做初筛与脱敏,把处理后的结果送到云端做深度处理。
三类任务分别往哪边放
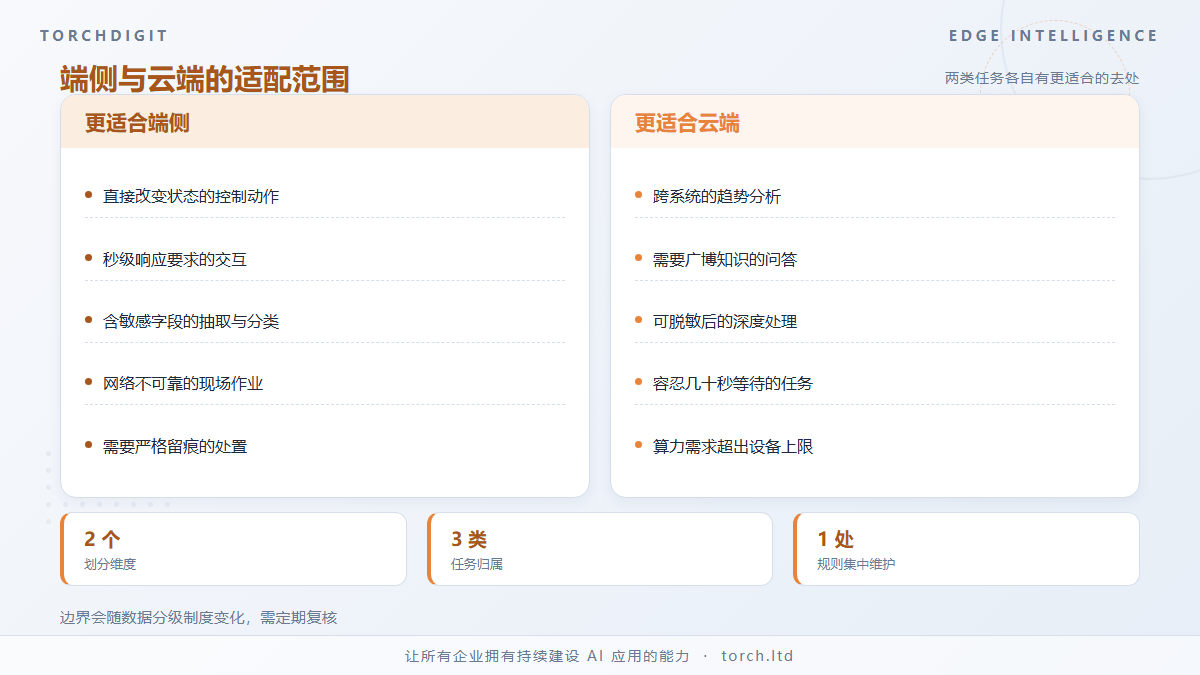
第一类是控制与执行。设备动作、流程触发、异常处置这类任务,既要求低延迟又要求可追溯,且直接改变物理或系统状态,放在本地最安全。网络上的一次抖动不应该导致产线停摆。
第二类是理解与抽取。单据识别、工单分类、字段抽取这类任务,输入往往包含业务数据,输出是结构化结果。放在本地的好处是原始数据不出设备,代价是模型规模受限,需要通过任务收敛来控制难度。
第三类是分析与建议。跨系统的趋势分析、多源信息综合、需要广博知识的问答,这类任务对算力要求高、对时延要求低,且输入通常可以脱敏,适合交给云端。
混合架构下的一致性怎么保证
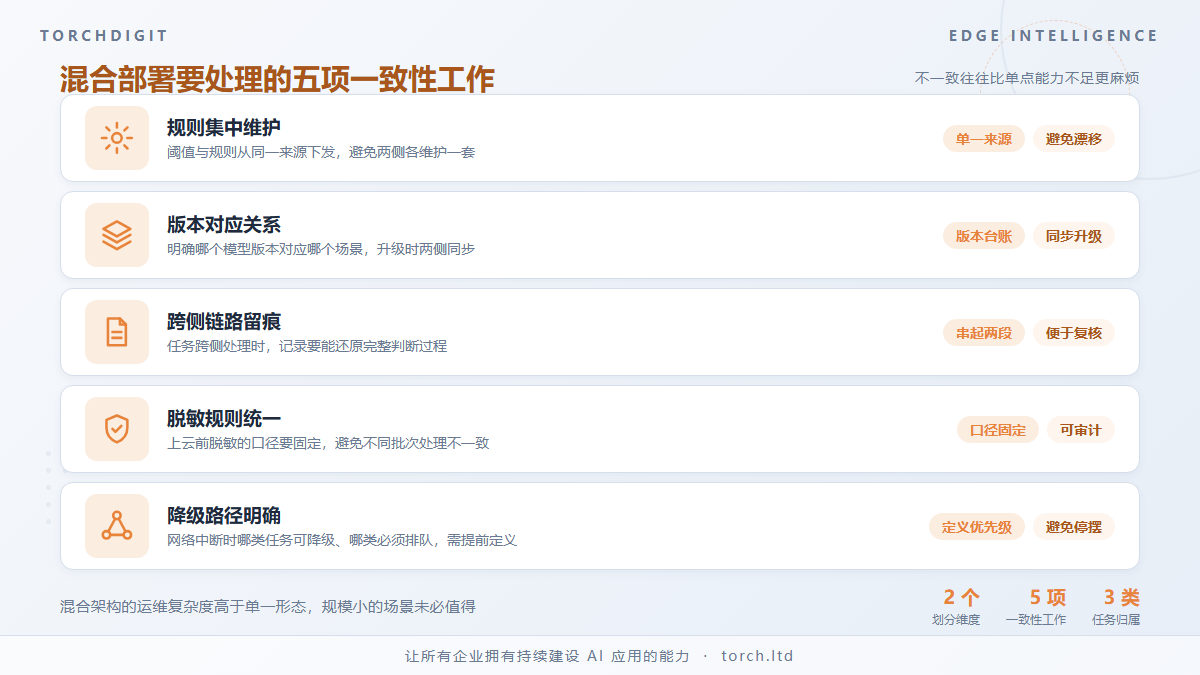
混合部署最容易出的问题不是单点能力,而是两侧行为不一致:同一个问题在本地和在云端得到不同答案,或者本地升级了规则而云端没有同步。
应对方式是把可变的判断逻辑收敛到一处。规则与阈值集中维护,本地与云端都从同一来源获取配置,避免各自维护一套。模型版本要建立对应关系,明确哪个版本对应哪个场景,升级时两侧同步而不是单独更新。
留痕要把两侧串起来。一个任务如果先本地处理再送云端,调用记录应能还原完整链路,包括在哪一侧做了哪些判断。否则出问题时只能看到一半过程。