端到端语音合成放弃离散分词器换来了什么
语音合成传统上走两段路:先把音频离散成码本单元,再按文本预测这些单元,最后还原成波形。端到端方案把这层离散化去掉,直接建模连续声学表征。换来的好处是合成更自然、训练数据利用率更高,代价是训练与部署的复杂度上升。
离散分词器原本承担对齐与压缩两个职责
在传统方案里,音频被量化成有限个码本单元,这一步同时解决了两件事。
第一是压缩。一段几秒的音频采样点数量巨大,直接建模计算量难以承受。离散化把连续波形映射到有限集合,序列长度大幅缩短,同时丢掉感知上不重要的细节。
第二是简化建模。把语音转成类似文字的离散序列后,就可以借用语言模型的思路,用「预测下一个单元」的方式训练,工程上成熟、容易复用。
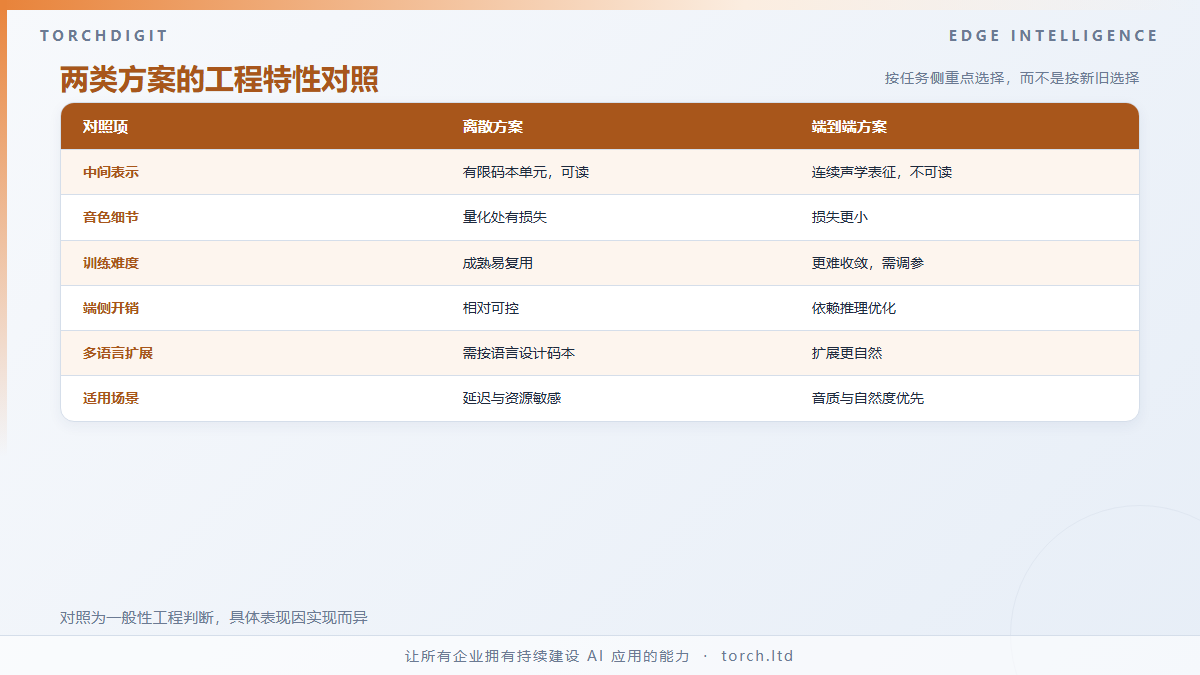
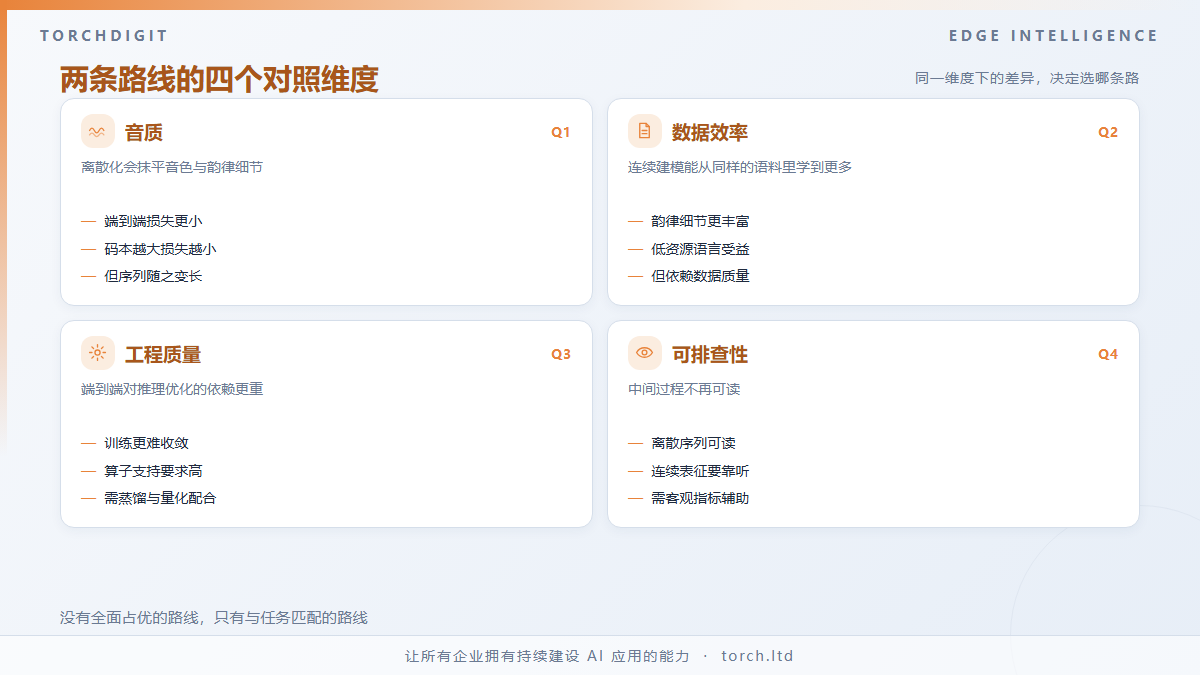
但离散化也带来损失。量化本身引入误差,码本大小有限时,音色的细节与韵律的微妙变化会在这一步被抹平。用较大码本能减少损失,但序列变长、训练变难。这是传统方案要反复权衡的地方。
去掉离散化之后,靠什么补上对齐与压缩
端到端的做法是直接预测连续的声学特征,把对齐交给模型自己学。这需要两个支撑。
一是更强的时长与韵律建模。没有离散单元作为中间锚点,模型必须从文本直接推出发音的时长与停顿。训练数据里要有足够的韵律变化,否则合成出来会平,像在念稿。
二是更精细的训练目标。连续表征的损失函数要同时兼顾频谱的准确性与感知的自然度,单纯最小化频谱误差会得到听起来发闷的结果。实践中通常把多种损失组合起来,让模型在准确与自然之间取得平衡。
工程上的补偿是推理加速。连续表征的生成比离散预测计算量大,端侧部署要靠蒸馏、低精度量化与缓存复用把延迟压下来。这也意味着端到端方案对推理引擎的依赖更深。
换来的收益与新增的成本
收益主要有三点。音质损失更小,因为音频不再经过一次有损的离散化;训练数据利用更充分,同样的语料能学到更多韵律细节;多语言与多方言的扩展更自然,不必为每种语言单独设计码本。
成本也很明确。训练更难收敛,需要更长的训练时间与更精细的调参;模型对推理引擎的算子支持更敏感,缺少对应优化时速度会明显下降;可解释性变差,中间过程不再是可读的离散序列,调问题时要靠听感与客观指标配合判断。
选择哪种方案取决于任务。对音质与自然度要求高的场景,端到端更合适;对延迟与资源极度敏感、且对音质要求不高的场景,离散方案仍有优势。