
从云端回到设备:这轮端侧 AI 热的底层原因
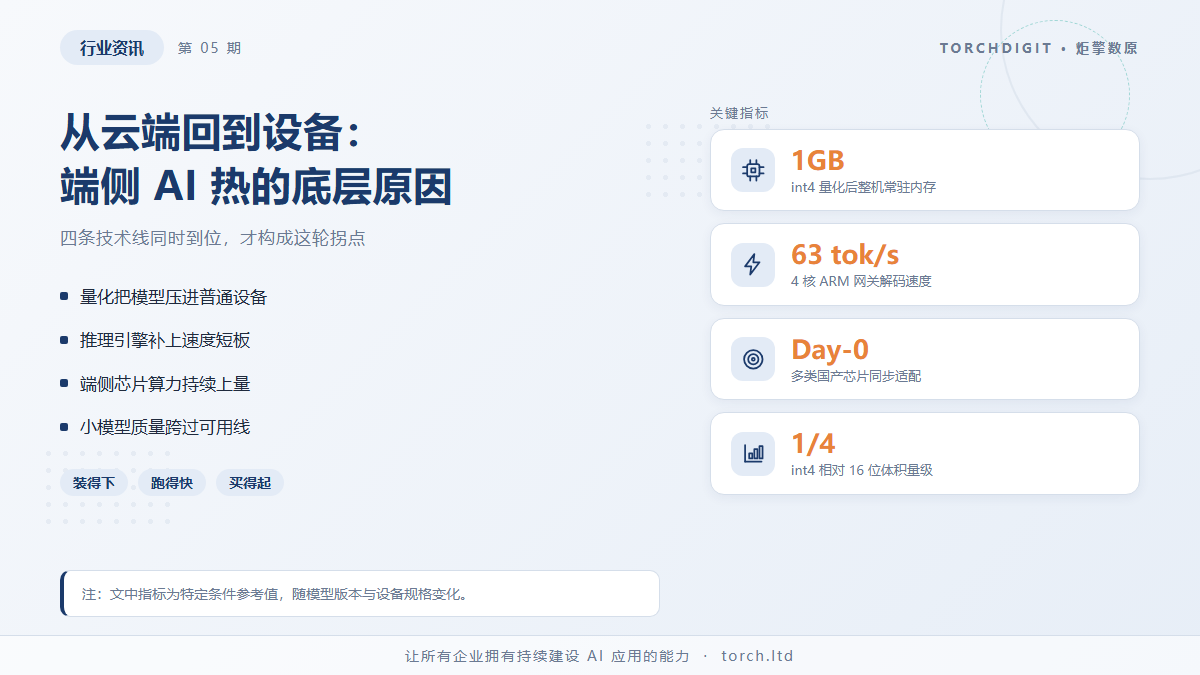
端侧 AI 不是新概念,嵌入式设备上跑小型模型已经有多年历史。这一轮的区别在于:跑在设备上的从「专用小工具」变成了「通用大语言模型」。变化不是单点突破,而是四条技术线同时到位的结果。拆开看,就能判断这轮热度里哪些是趋势、哪些是噪音。
量化技术把模型压进了普通设备
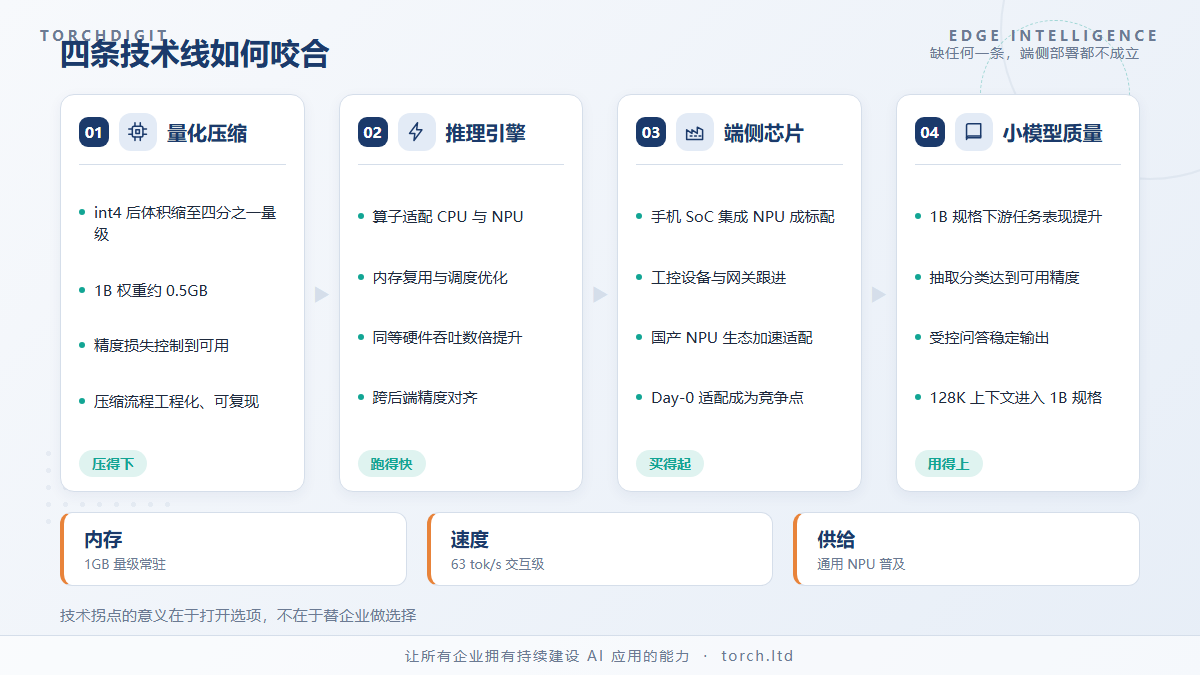
第一条线是量化。把模型权重从 16 位浮点压到 int4,体积缩小到原来的四分之一左右——1B 参数模型量化后权重约 0.5GB,加上运行时开销,整机常驻内存落在 1GB 量级。这个数字意味着普通工控网关、消费级笔记本都装得下。
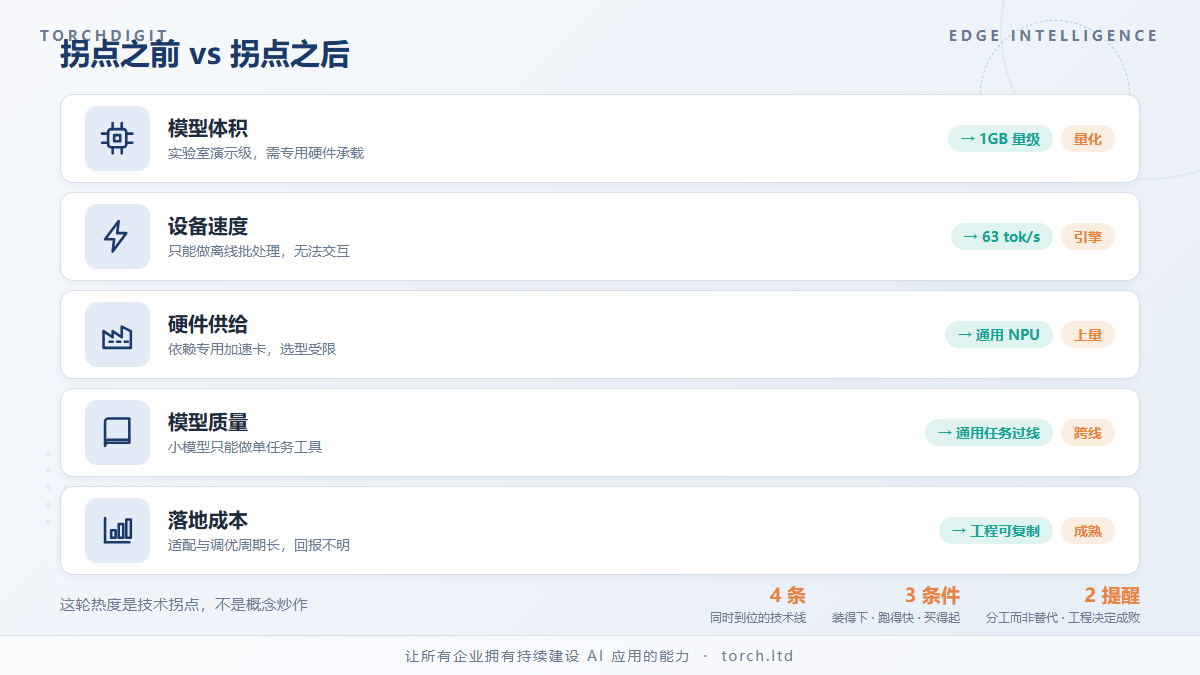
量化的难点从来不是压缩本身,而是压完之后精度掉多少。近几年量化算法的改进,让 int4 方案在多数下游任务上的精度损失控制在了可接受范围。压得下、用得起,端侧部署才从「实验室演示」变成「工程选项」。
推理引擎补上了速度短板
第二条线是推理引擎。有了小模型,还要跑得快。端侧设备多数没有独立 GPU,推理引擎要在 CPU 与 NPU 上把解码速度做出来。以 4 核 ARM 无风扇工业网关为例,1B 模型做到 63 tok/s,才够支撑交互式使用——这个速度三五年前只能在服务器上实现。
引擎层面的优化——算子适配、内存复用、调度策略——没有模型架构那样引人注目,但正是这类工程积累,让同样的硬件跑出了数倍于以前的吞吐。
端侧芯片算力在持续上量
第三条线是硬件。手机 SoC 集成 NPU 已经成为标配,工控设备、网关、一体机也开始搭载具备 AI 加速能力的芯片。国产 NPU 生态近两年加速适配主流开源模型,多类芯片实现了新模型发布当天的适配支持。
算力供给跟上后,端侧部署的硬件成本曲线持续下移。装得下、跑得快、买得起,三个条件第一次同时成立。
小模型质量跨过了可用线
第四条线在模型本身。同样的参数规模,新模型的下游任务表现明显好于两年前的同类。1B 规格模型在抽取、分类、受控问答等任务上达到可用精度,让「设备上跑通用模型」从概念变成现实——这是四条线里最根本的一条,其他三条都是在为它铺路。
趋势判断与提醒
四条线叠起来解释了这轮热度的成色:它是技术成熟度到了拐点,不是概念炒作。但两个提醒同样必要。其一,端侧与云端是分工而非替代,云端在大算力与知识时效上的优势没有变化。其二,端侧方案的落地质量取决于工程细节——量化方案选择、设备适配、场景测试——跳过这些环节直接套用宣传参数,落地大概率不及预期。