
端侧与云端不是二选一:哪些任务该留在本地
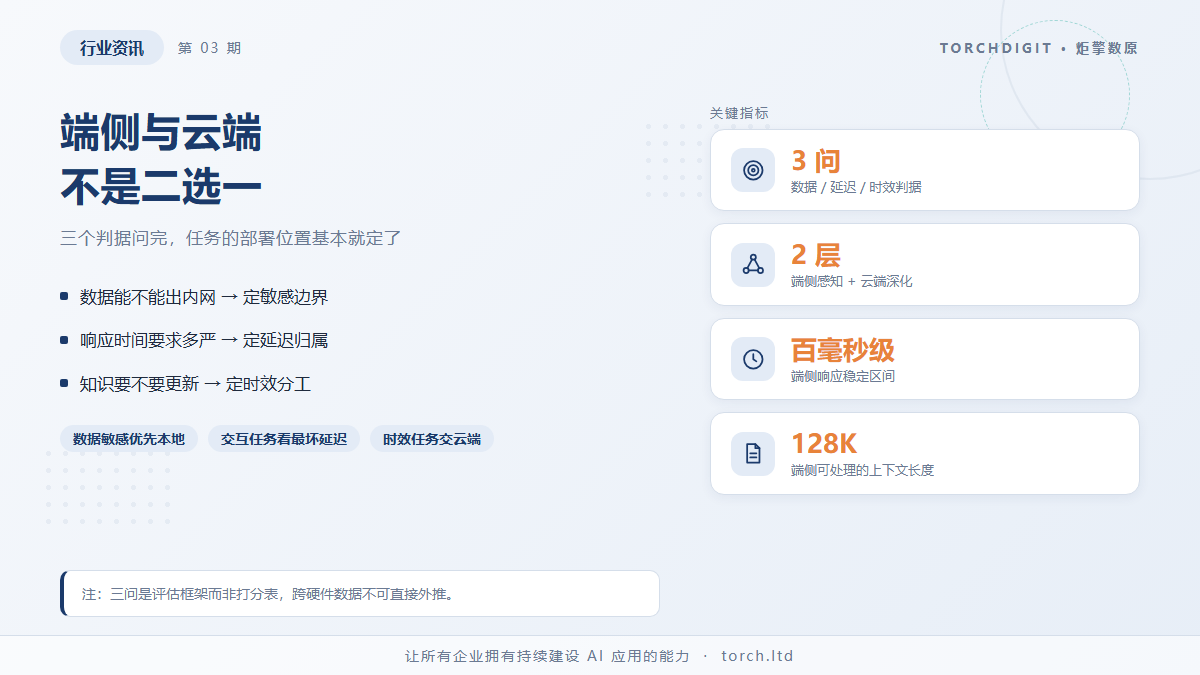
讨论端侧 AI 时最容易走偏的思路,是把「上云还是本地」当成一道单选题。实际部署里,两者更接近一条分诊线:每个任务按属性被分到不同位置,多数企业的最终形态是端云组合。分诊的依据有三个,三个问题问完,任务的部署位置基本就定了。
第一问:数据能不能出内网
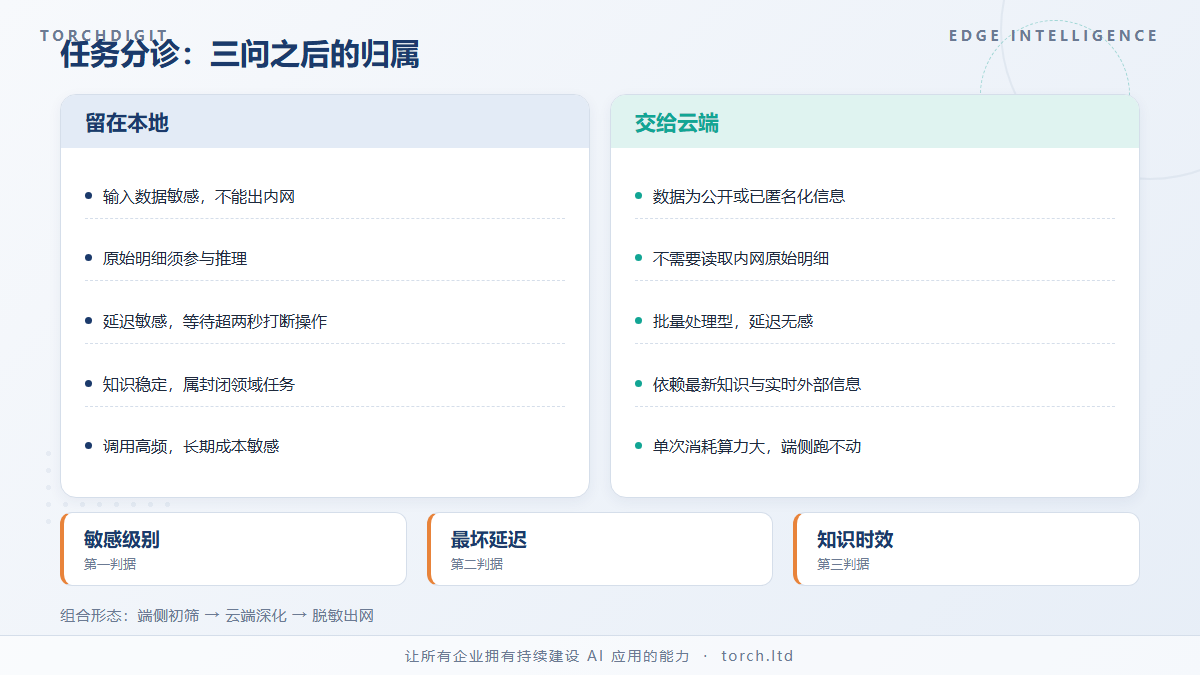
第一个判据是数据敏感级别。任务输入若是单据、图纸、巡检记录、内部纪要这类不适合外发的内容,优先考虑端侧——模型到数据旁边去,省掉整条脱敏与审批链路。
判断时要区分「数据本身敏感」与「数据经过加工后敏感」。已经匿名化的统计指标、公开的行业文本,放在云端处理没有障碍。真正卡住架构的是原始明细数据,而任务恰恰要读明细。这类任务的归属,从数据定级那一刻就基本确定了。
第二问:响应时间要求有多严
第二个判据是延迟。云端推理的响应时间受网络排队与服务端负载影响,是一个区间;端侧推理由设备决定,稳定在百毫秒到秒级。任务对「最坏情况」越敏感,越适合放本地。
具体说,人机交互型任务——现场问答、单据核验、告警诊断——容忍度低,等待超过两秒就会打断操作。批量处理型任务——夜间报告汇总、历史档案整理——晚几秒无感。前者是端侧的主场,后者交给云端更划算。
第三问:知识要不要更新
第三个判据是知识时效。端侧模型的知识截止于它发布的那一刻,无法自行获取新信息。任务依赖最新行业动态、实时行情或频繁变化的规则库,放端侧效果不会更好。
适合端侧的是知识相对稳定的任务:固定领域术语抽取、设备故障模式识别、格式化文档处理。这些任务的判断依据沉淀在模型参数与提示词模板里,不依赖外部实时数据。需要外部知识的任务,可以让端侧负责理解与初筛、云端负责取数与综合,分工处理。
组合形态才是常态
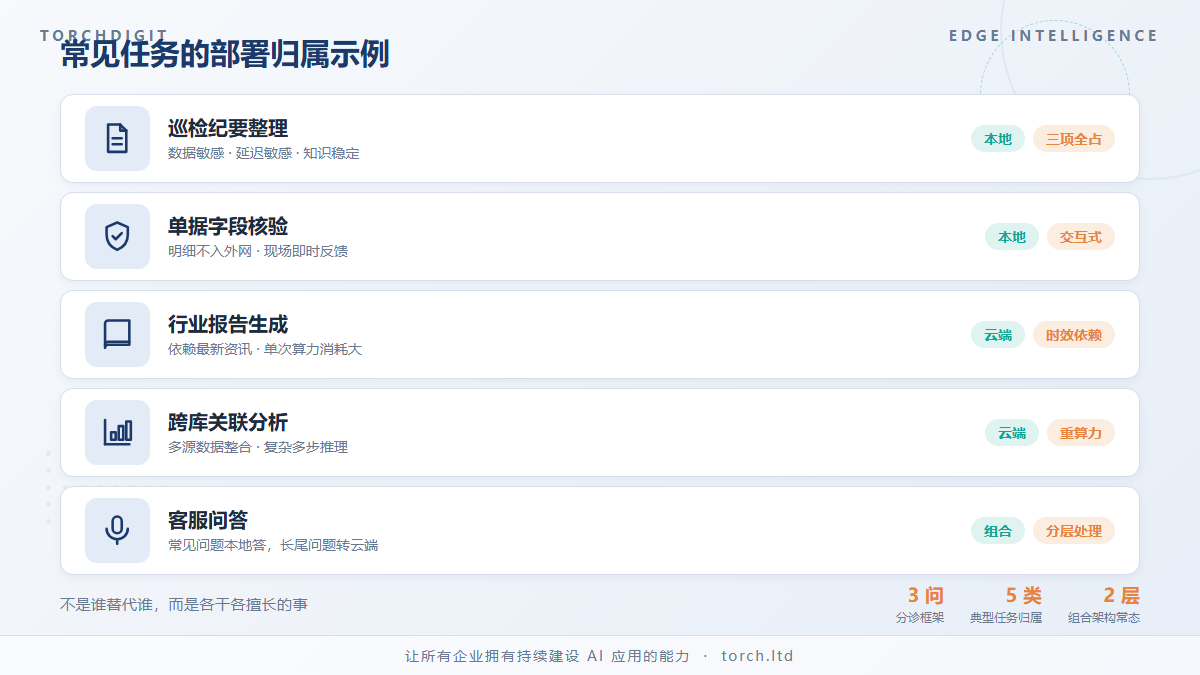
三个判据在实际业务里往往交叉:巡检纪要整理数据敏感、延迟要求高、知识稳定,三项全占,是标准的端侧任务;行业报告生成依赖最新资讯、算力消耗大、数据不敏感,是标准的云端任务;更多任务居中,比如客服问答——常见问题走本地,长尾问题转云端。
常见的落地形态是端侧承担感知与初步判断,把需要更大算力或外部知识的部分交给云端,敏感字段在本地脱敏后再出网。架构因此分成两层,各干各擅长的事。