端侧 AI 的下一步:从单设备到设备群的协同
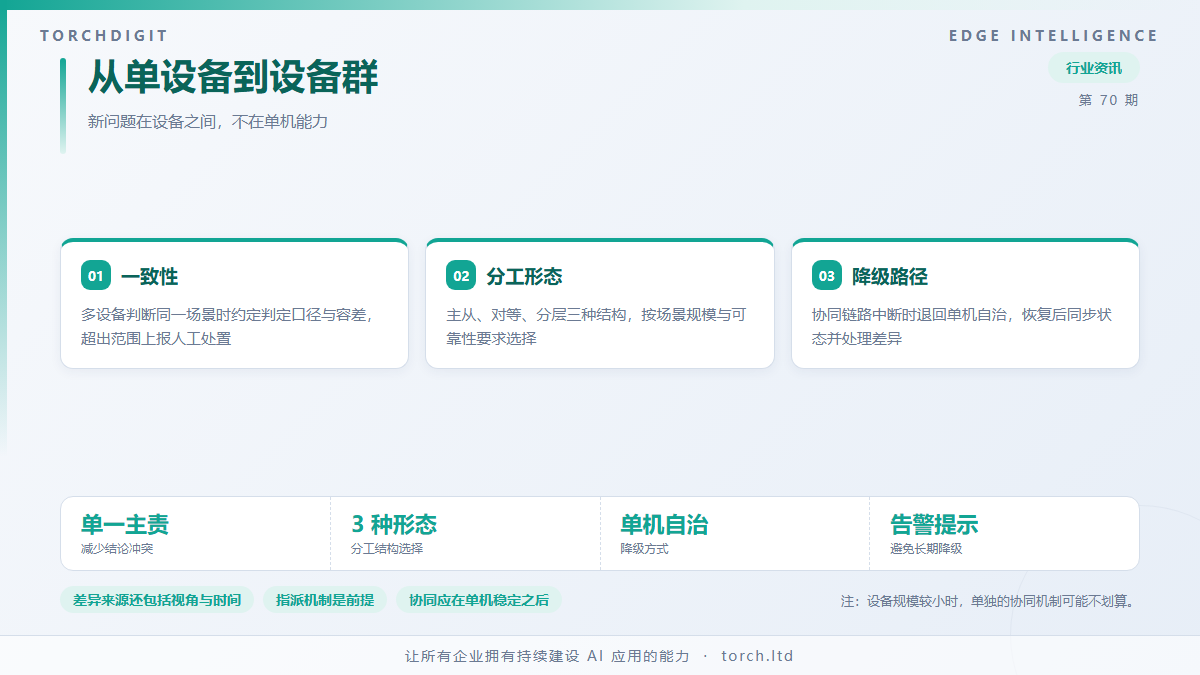
单台设备的端侧智能体解决的是本地响应问题。当设备数量增加、场景开始交叉时,新的问题出现了:多台设备看同一件事,结果不一致怎么办;现场出现异常时,由哪台设备负责响应。这类问题指向的是设备之间的协同,而不是单机能力。
协同时首先要解决一致性问题
多台设备同时对同一场景作出判断时,结果可能不同。设备型号不同、模型版本不同、感知条件不同,都会带来差异。
处理方式与多后端一致性类似:约定判定口径与容差范围,超出的情况上报人工处置。区别在于设备群的差异来源更多,还包括视角不同与时间异步。
更实际的做法是明确职责划分。同一任务只由一台设备主责,其余设备提供辅助信息而不独立决策,这样可以减少结论冲突,代价是需要在设备间建立明确的指派机制。
分工方式决定协同的形态
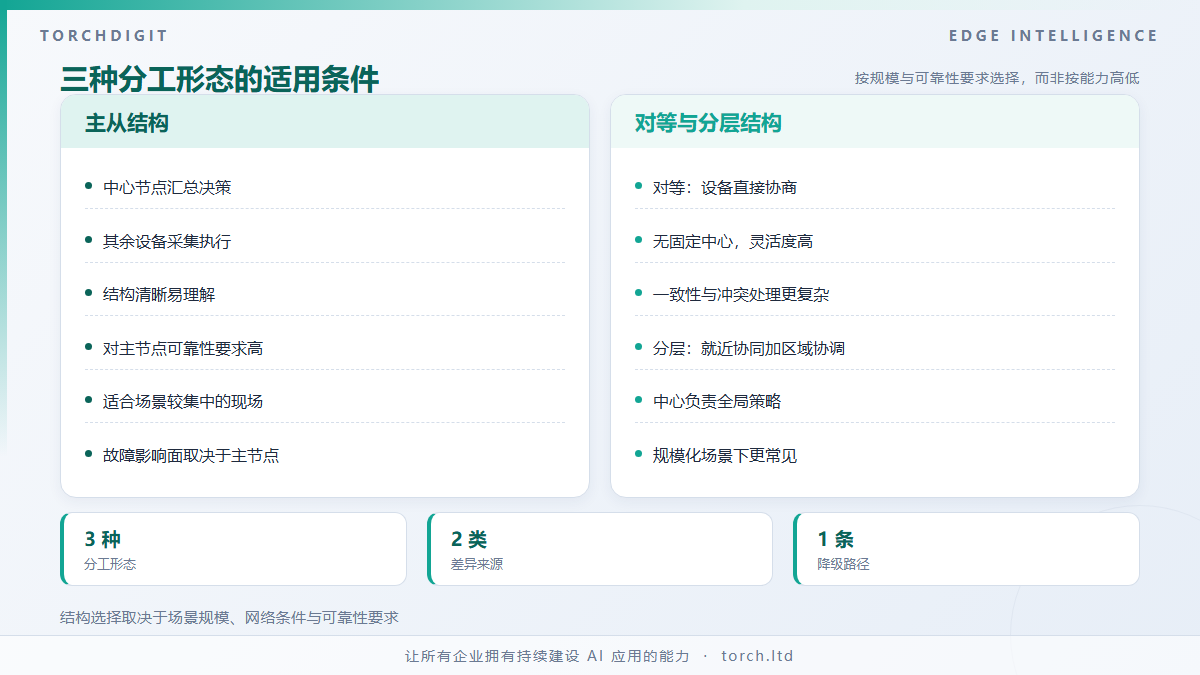
设备群的分工大致有三种形态。
一是主从结构。中心设备或边缘节点负责汇总与决策,其余设备负责采集与执行。结构清晰,但对主节点的可靠性要求高。
二是对等结构。设备之间直接协商,没有固定中心。灵活度高,但一致性与冲突处理更复杂。
三是分层结构。现场设备就近协同,区域节点负责跨区域协调,中心负责全局策略。这是规模化场景下较常见的形态。
选择哪种结构取决于场景规模、网络条件与可靠性要求,而不是能力高低。结构一旦确定,设备之间的接口与数据格式需要相应固定。
协同要留出降级路径
设备之间依赖通信,而通信本身可能不可靠。当协同链路中断时,系统需要有明确的降级方式。
可行的降级是退回单机自治:每台设备按预设规则独立运行,保证基本功能不中断。协同恢复后再同步状态,处理期间形成的差异。
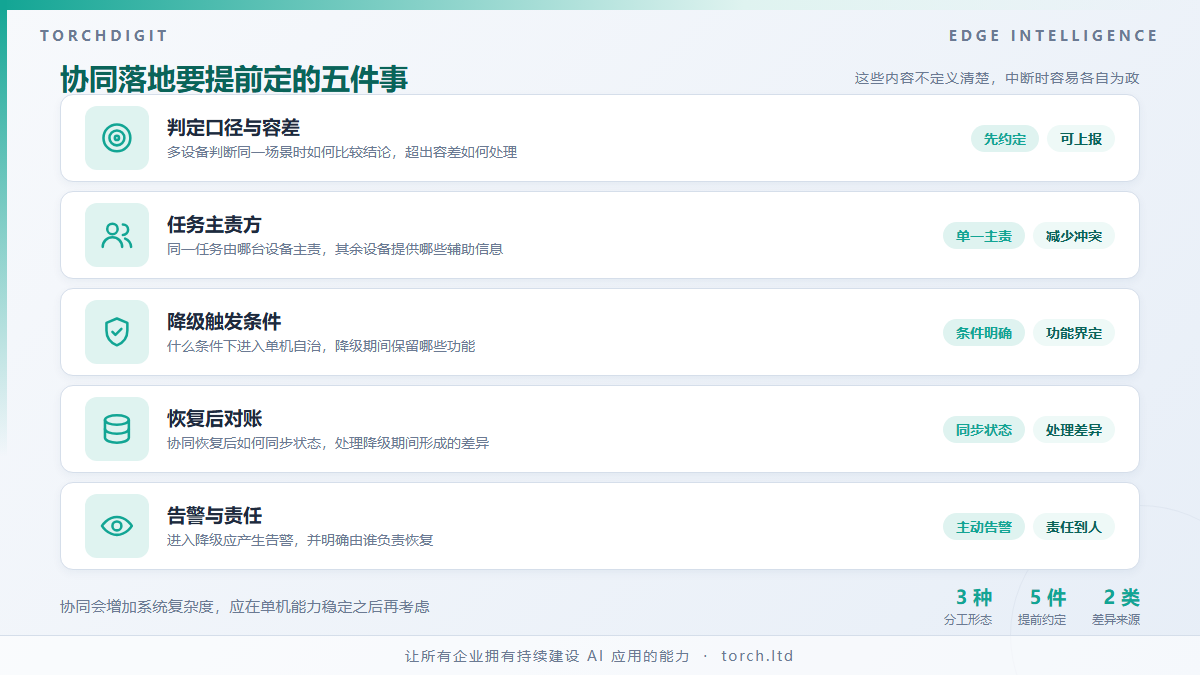
降级规则需要提前定义:什么条件下进入降级、降级期间哪些功能保留、恢复后如何对账。这些内容不定义清楚,协同中断时容易出现各自为政的情况。
同时要避免降级状态长期存在而无人发现。进入降级应当产生告警,并明确由谁负责恢复。恢复过程本身也应当留痕,便于判断降级发生的频率与原因。