端侧 AI 的 POC 该怎么设计才算有效
POC 的目的常常被理解反了。它不是用来证明方案可行的,而是用来在低成本阶段暴露问题的。设计得当的 POC 能在几周内回答方案能否成立、代价有多大;设计不当的 POC 通常只产出一份演示记录,进入实施阶段后问题照旧出现。
先确定要回答的问题
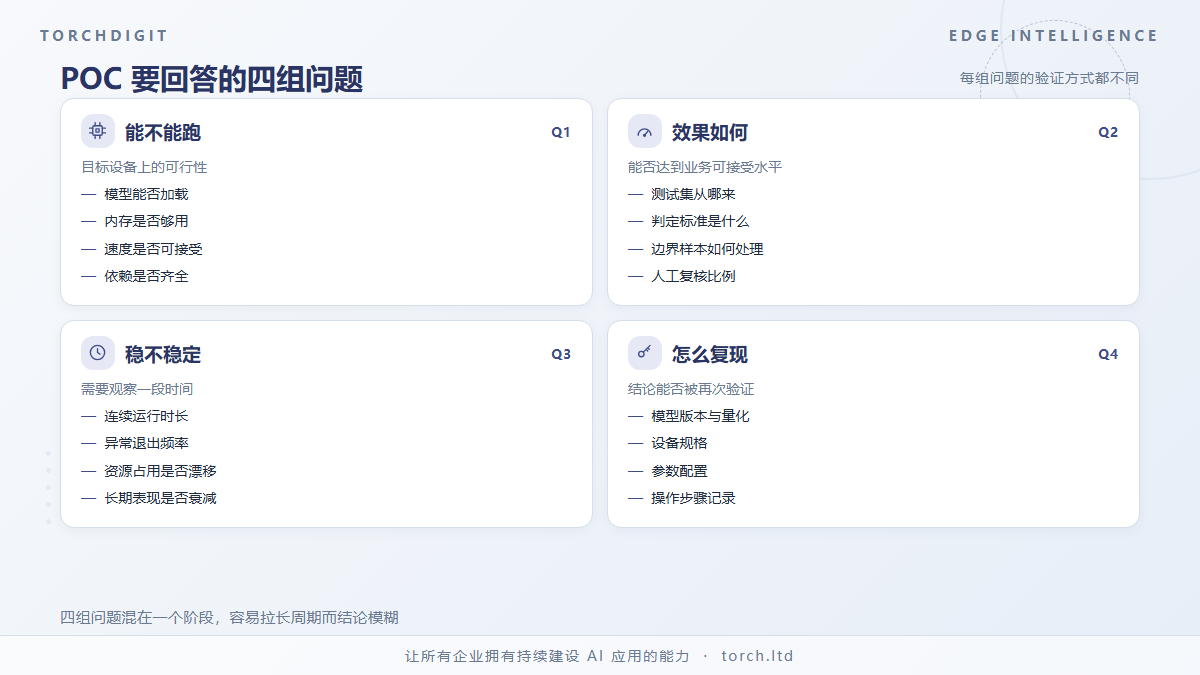
POC 开始前,需要先把要回答的问题列出来。常见的核心问题有三个:目标设备能不能跑起来,效果能不能达到业务可接受的水平,现场条件下稳定性如何。
这三个问题的验证方式完全不同。能不能跑起来是环境问题,通常在几天内就能得出结论;效果是否达标需要准备测试集;稳定性则需要观察一段时间,短时间的运行结果说明不了问题。
如果把这几个问题混在一个阶段里,往往导致 POC 时长被拉长,而结论仍然模糊。更高效的做法是分阶段推进:先做可行性验证,再评估效果,最后看稳定性。
测试数据要贴近真实分布
端侧 AI 的 POC 里,测试数据的准备是最容易被低估的一环。用公开数据集或整理过的样例,得到的结果通常好于现场实际情况。
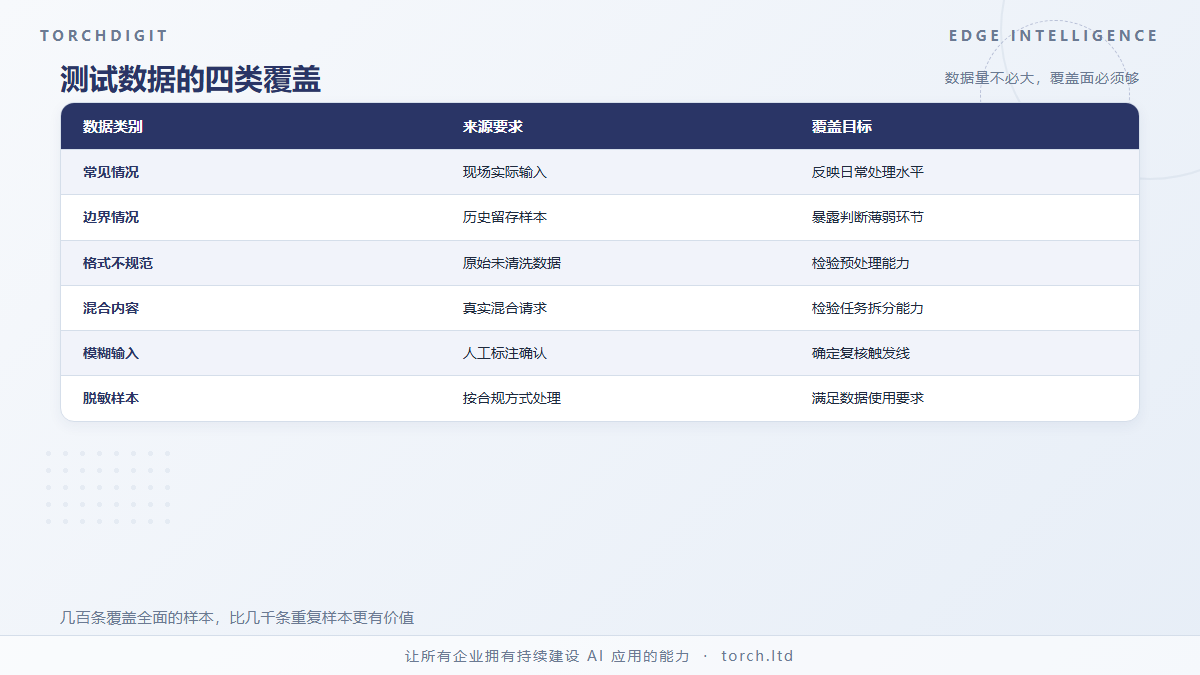
贴近真实的数据至少要满足两个条件。一是来源真实,用现场实际产生或历史留存的输入,而不是人工构造的样例。二是分布接近,包含常见情况,也包含边界情况,例如模糊的输入、格式不规范的数据、同时包含多种内容的混合请求。
数据量不需要很大,但覆盖面要够。几百条覆盖全面的样本,比几千条重复的样本更有价值。
还要注意数据的合规使用。涉及客户信息或敏感数据时,脱敏方式要在 POC 阶段确定,不能等到上线前再处理。
结果要能复现并留档
POC 结论如果无法复现,价值有限。同一批数据、同一套配置、同样的操作步骤,应当能得到接近的结果。
这就要求记录完整:使用的模型版本、量化方式、运行设备规格、参数配置都要写明。缺少任何一项,后续复现时都可能出现结果对不上的情况,而排查这种差异非常耗时。
结论也要留档,包括达成与未达成的部分。未达成的结论同样有价值,它划定了方案的边界,避免后续重复投入。测试集本身应当保留,作为上线后的回归基准。