行业资讯
2026-09-28 · 次阅读
长文档处理为什么成了法律场景的硬需求
小编
TorchDigit
法律工作处理的对象本身就是长文档:合同、判决书、尽调材料、监管文件,动辄数十页。传统的文本处理方式需要人工分段阅读,效率受限于人的阅读速度。当处理能力提升到可以一次读入整份文档时,工作方式发生了变化,也带来了新的技术要求。
需求来自文档处理的三个特点
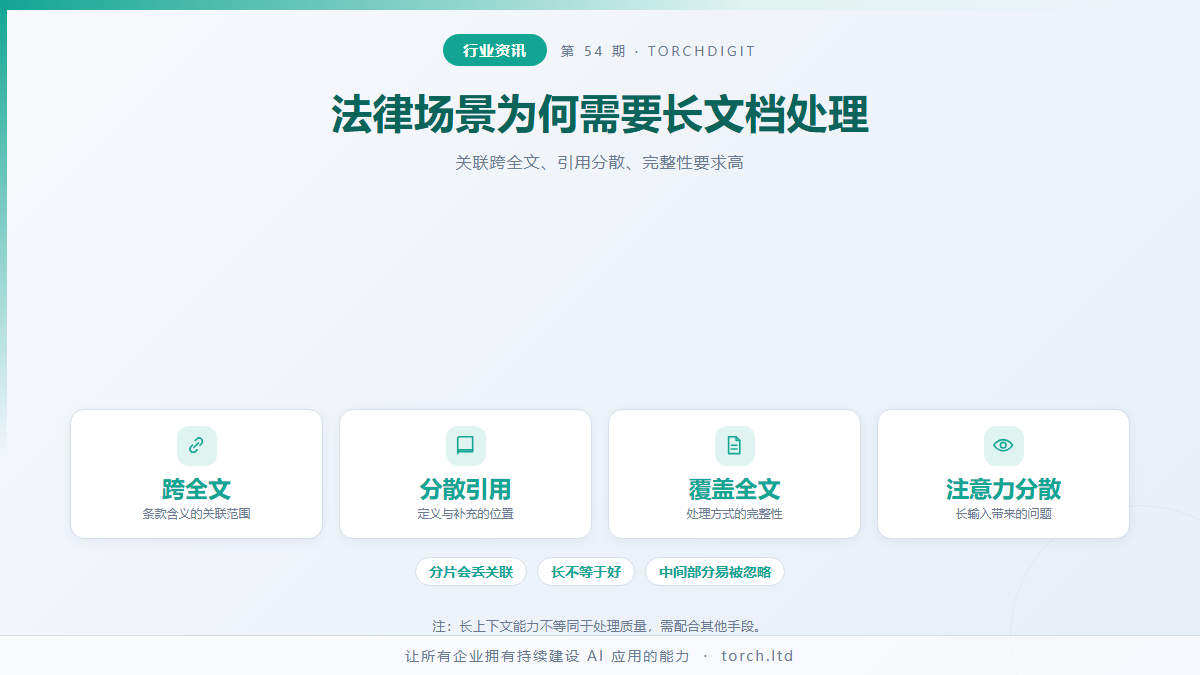
第一是关联性跨越全文。一个条款的含义往往取决于其他条款的约定,单独看一节容易误判。分片处理的方式容易丢失这种跨段落的关联,导致结论片面。
第二是引用与定义分散。法律文档常在开头定义术语,在中间引用,在附件中补充。处理时需要在全文范围内建立这些对应关系,而不是逐段独立理解。
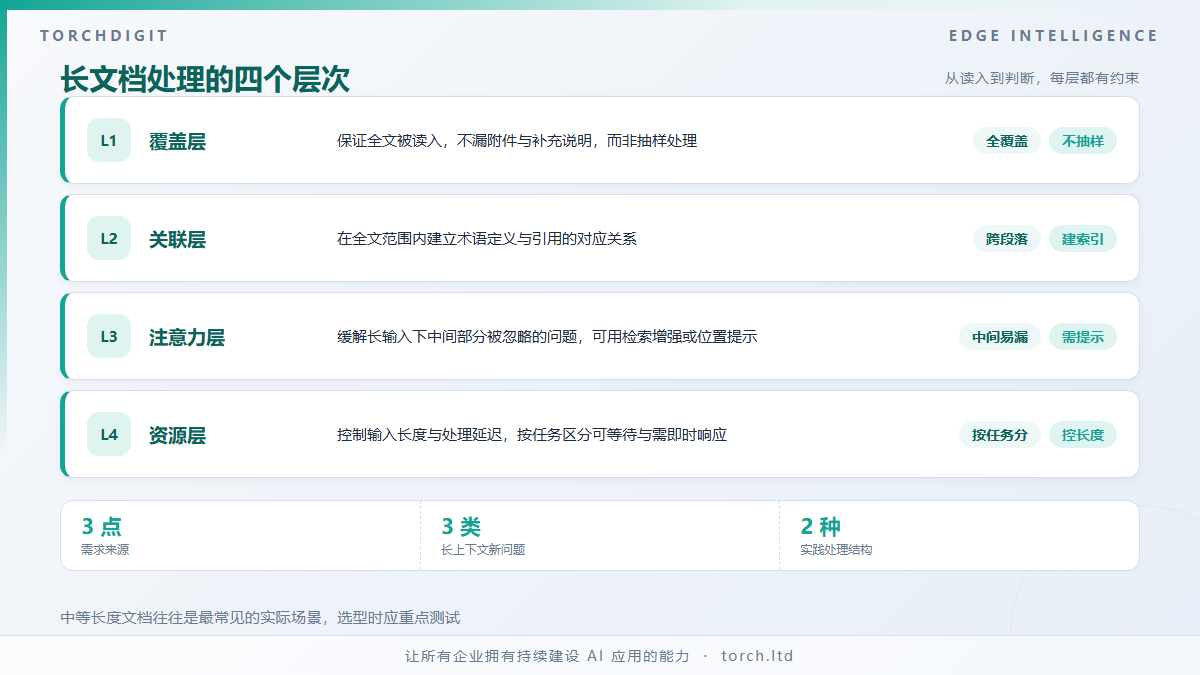
第三是完整性要求高。漏掉一个附件或一段补充说明,可能改变整个判断。因此处理方式必须保证覆盖全文,而不是抽样。
这三点共同指向一个技术需求:能够一次性容纳并理解整份文档的处理能力。
长上下文带来的新问题
能够读入整份文档只是第一步,随之而来的是新的工程问题。
注意力分散。输入越长,模型对中间部分的关注度往往低于开头与结尾。对法律文档来说,中间部分恰恰可能包含关键约定。这个问题需要通过检索增强或位置提示来缓解。
处理延迟。长输入的处理时间显著增加,交互式使用时会感到等待。因此需要区分场景:需要快速响应的咨询类任务与可以等待的审查类任务,处理方式应当不同。
成本与资源。长输入意味着更大的内存占用与更长的处理时间,本地设备上的资源限制更明显。按要求控制输入长度、采用分段加汇总的策略,是常见的应对方式。
实践中的处理方式
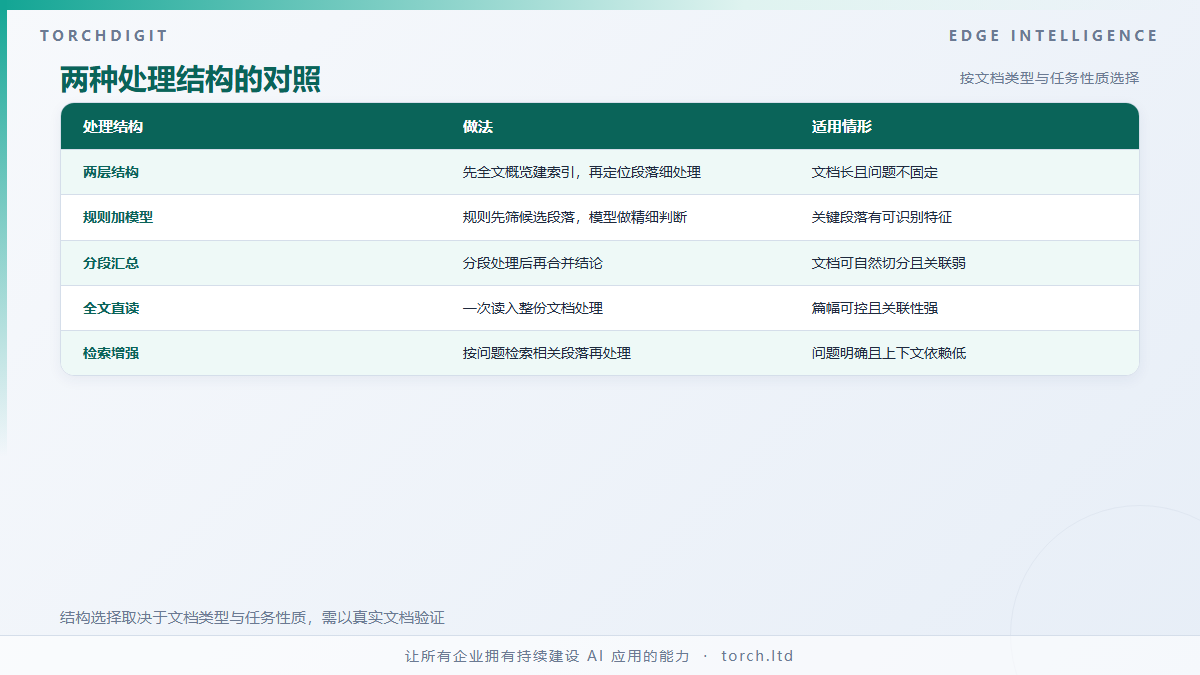
一种可行的结构是分两层。第一层做全文概览,建立文档的整体结构索引,识别各部分主题与相互关系。第二层按具体问题定位到相关段落,做细致处理。这样既保证了全文覆盖,又避免了每次都在全文上做深度推理。
另一种是先用规则方法定位候选段落,再交给模型处理。规则方法负责大范围筛选,模型负责精细判断,两者配合可以减少对长上下文的依赖。