
1.3B 视觉模型跑在 6GB 内存设备上:多模态的落地边界
把视觉模型放到端侧,难点不在模型本身多大,而在于图像进入模型的那一段开销常被低估。1.3B 级别的视觉语言模型能跑在 6GB 内存设备上,前提是把图像编码、分块策略与上下文长度一起算进去。只按权重估内存,会得出一个漂亮但用不了的结论。
图像编码与分块,是内存里最容易被忽略的一段
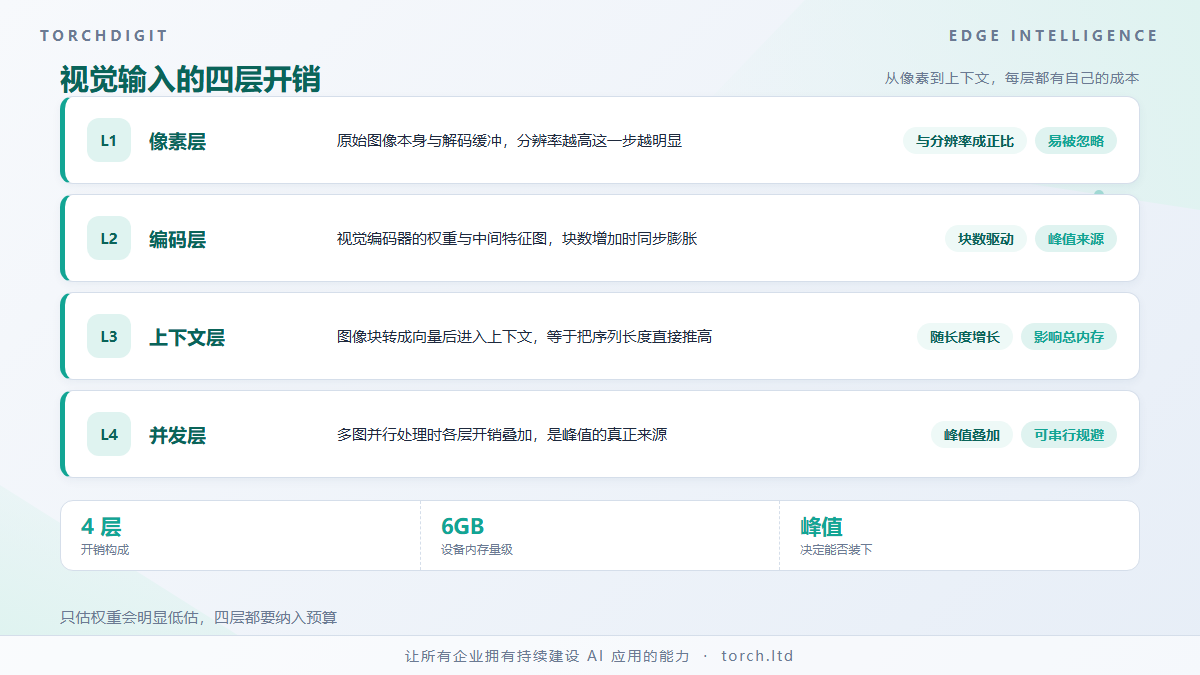
视觉模型的输入不是文本,而是一张图或多张图被切分成的图像块序列。一张高分辨率图片会被切成几百个块,每个块都要经过视觉编码器转成向量,再作为上下文喂给语言模型。这段开销有两次放大。
第一次放大在编码阶段。视觉编码器本身要占内存,分辨率越高、块数越多,中间特征图越大。第二次放大在上下文阶段。图像块转换后的向量会进入语言模型的上下文,等于把上下文长度直接推高,而上下文缓存的内存是随长度增长的。
所以「1.3B 模型占多少内存」这个问题问得不完整,应该问「处理一张多少分辨率的图、几张图,峰值内存是多少」。这两个数字差一倍并不罕见。
分辨率与分块策略,决定精度与开销的平衡
提高分辨率通常能改善小目标与文字识别效果,代价是块数增加、上下文变长、内存与延迟同步上升。降低分辨率省资源,但会丢掉细节,对表格、票据这类密集文本的识别影响明显。
实用的做法是按任务定策略,而不是全局统一。需要读文字的场景保留高分辨率并限制每次处理的图片数量;只需要判断有无、识别大致类别的场景降低分辨率并允许批量处理。分块大小也可以调:块切得大,上下文短但细节损失多;块切得小,细节保留好但上下文迅速膨胀。
另一个可以主动控制的是并发。多张图同时处理会让峰值内存叠加,串行处理虽然慢,但峰值可控。设备内存有限时,串行往往是唯一能稳定跑通的方式。
落地边界:能做判断与抽取,不要指望逐字级的精确复现
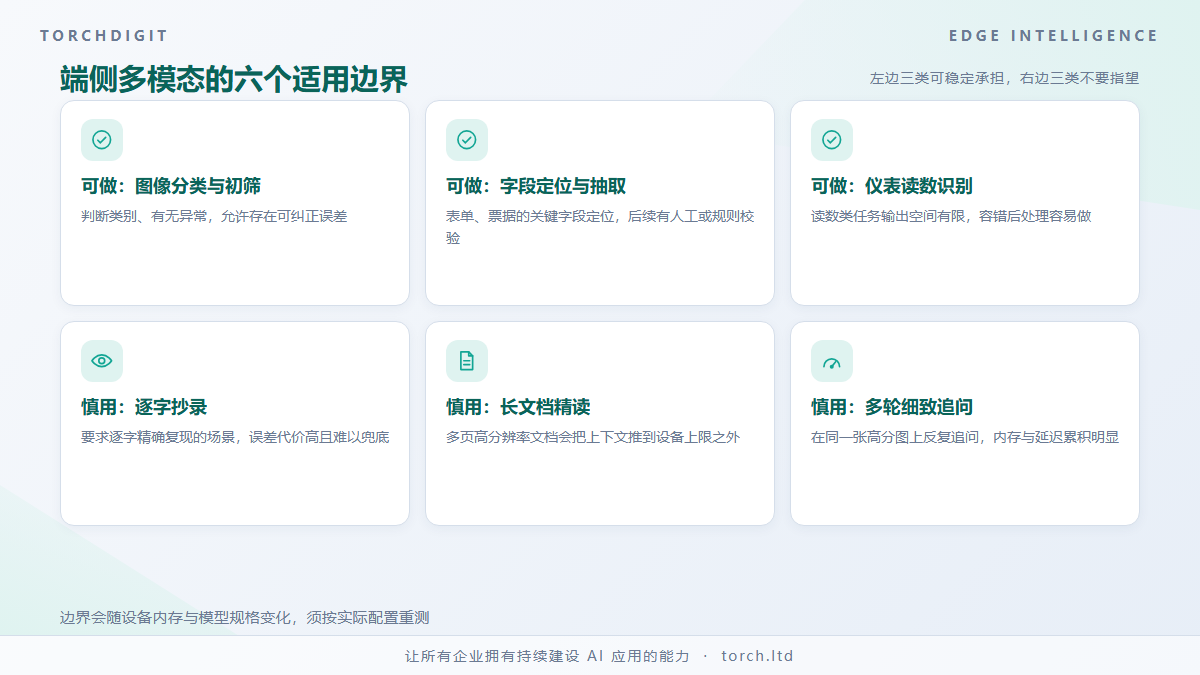
在 6GB 内存级别的设备上,视觉模型能稳定承担的是「看一眼并给出结论」类任务:图像分类、缺陷初筛、表单字段定位、仪表读数识别、场景描述。这类任务的共同点是不要求逐字精确,允许存在可纠正的误差,且后续有校验环节兜底。
不适合的是需要长文档级精读、逐字抄录、或在单张高分辨率图上做多轮细致追问的场景。这些任务会把上下文与内存需求推到设备上限之外,勉强运行也会在并发或连续使用后暴露问题。
边界说明
本文讨论的内存与分辨率关系是量级判断,具体可用配置必须在目标设备上用真实图片实测,尤其是业务中常见的最大尺寸与最差质量的图片。不同视觉编码器的开销差异较大,换模型后需要重新评估。此外,压缩与量化对视觉分支的影响通常大于对文本分支的影响,量化后应单独验证识别类任务的精度落差。建议先用一批真实图片做压力测试,确认峰值内存与最坏情况下的延迟,再决定是否上线。