21% 训练开销追平同级基座:一条端侧模型的训练路径
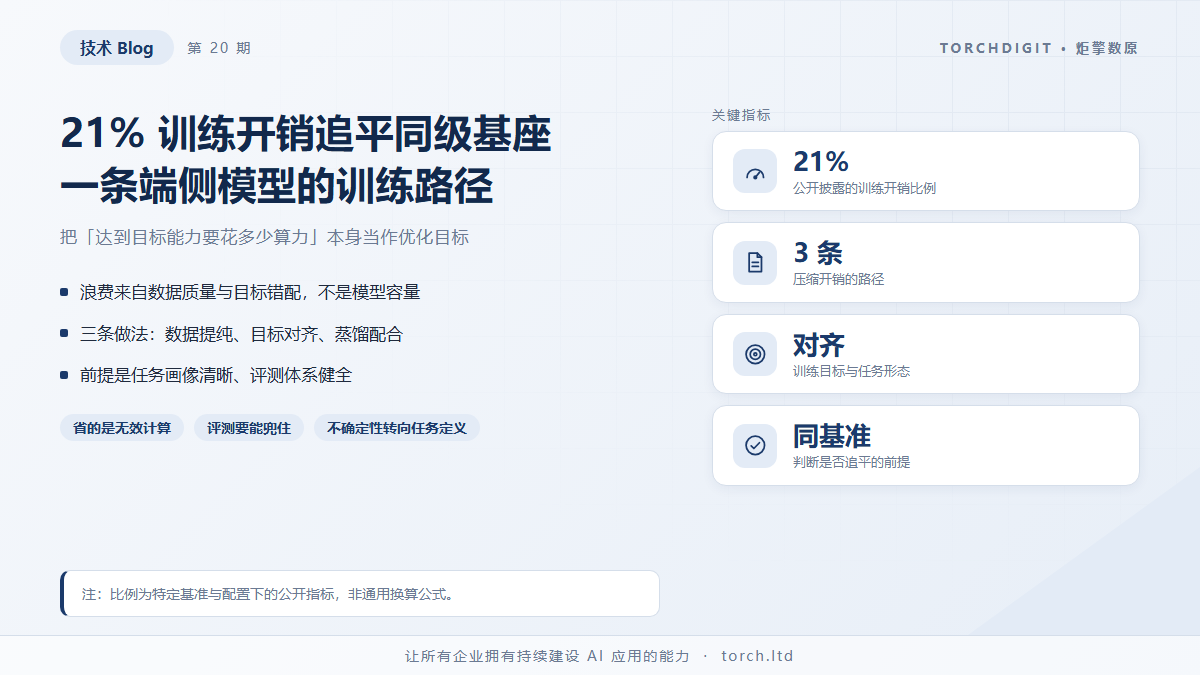
端侧模型的训练长期被当作规模竞赛的附属品——先有基座,再压缩适配。但如果把「达到目标能力需要多少训练开销」本身当作优化目标,路径会完全不同。按炬擎数原公开的技术说明,在相同评测基准与训练数据规模下,其端侧模型达到与同级基座接近的下游任务表现,所需训练算力约为后者的 21%。这个数字背后是一组具体的工程选择。
省下来的不是参数量,是无效计算
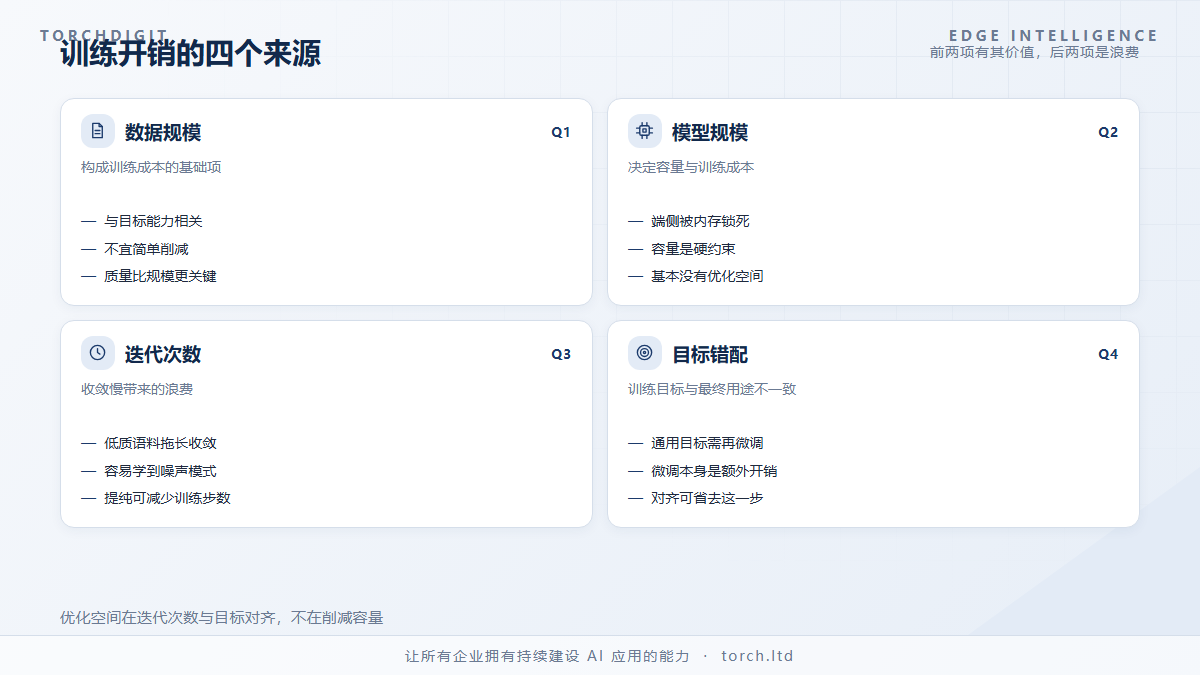
训练开销由三部分构成:数据规模、模型规模、以及达到收敛所需的迭代次数。压缩前两项通常意味着降低最终能力,真正有优化空间的是第三项。
迭代次数的浪费主要来自两个方向。一是数据质量参差,模型在低信息密度的语料上反复训练,收敛慢且容易学到噪声模式;二是训练目标与最终用途不匹配,用通用目标训练出来的模型,在端侧高频任务上需要额外微调才能达到可用水平,这部分微调本身就构成额外开销。
把这两处浪费收掉,是压缩训练开销的主要空间,而不是削减模型容量。
三条具体做法
第一条是数据侧的提纯与配比。在训练语料上做更严格的去重、质量筛选与领域配比,让每个训练步都携带更多有效信息。数据提纯的收益不是线性的,但当低质量语料占比明显下降时,收敛所需的步数会有可观减少。
第二条是训练目标的对齐。把企业高频任务的形态引入训练阶段,比如抽取、分类、受控问答,而不是只在通用语料上训练后再做下游适配。目标对齐带来的收益是双重的:收敛更快,并且模型在目标任务上的表现更接近最终交付形态。
第三条是蒸馏与结构约束的配合。用能力更强的模型提供监督信号,让小模型在有限容量内学到更接近教师模型的行为分布;同时在结构设计阶段就考虑后续的量化需求,避免训练出一个「精度很高但一压就崩」的模型。
判断这条路径是否适合自己
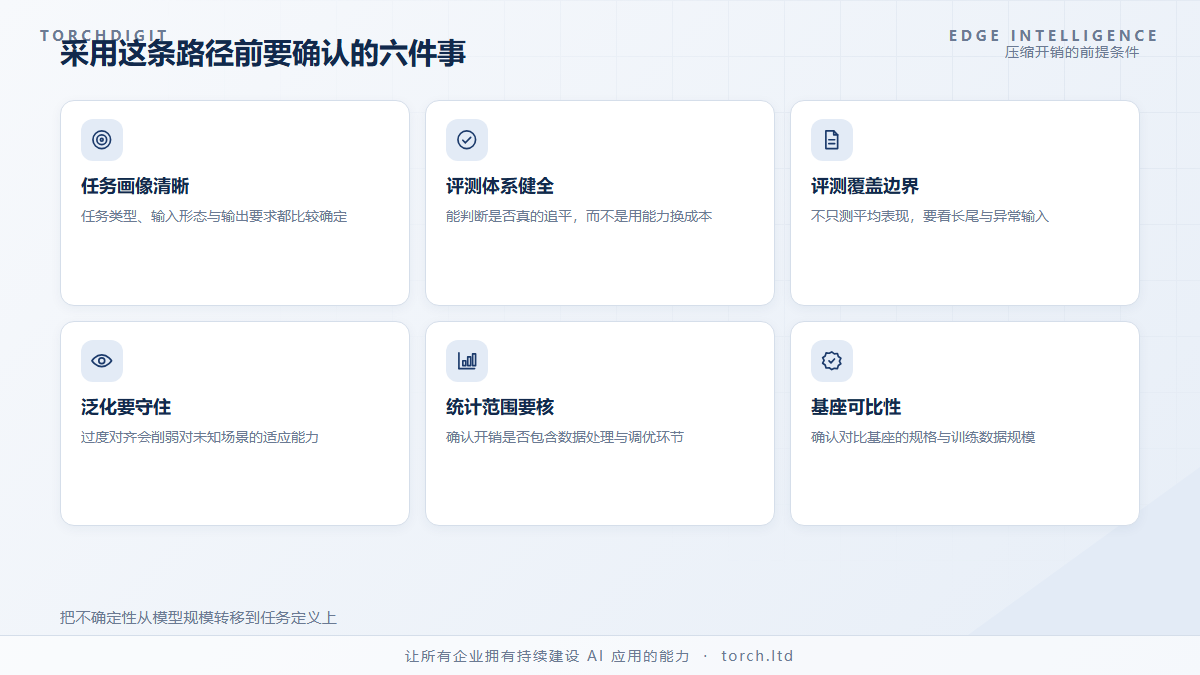
这条路径的前提是任务画像清晰。只有当目标任务的类型、输入形态与输出要求都比较确定时,训练目标的对齐才有落点。如果任务是开放的、需要覆盖大量未知场景,过度对齐反而会削弱泛化能力。
另一个前提是评测体系健全。压缩训练开销的过程中,判断「是否追平」必须依赖稳定的评测,否则很容易在不知不觉中用能力换成本。评测集要覆盖目标任务的边界情况,而不能只测平均表现。
对多数企业而言,真正有价值的不是自己复现这条路径,而是理解它的含义:一个端侧模型的训练成本,可以在不牺牲目标能力的前提下显著下降,代价是把不确定性从模型规模转移到了任务定义上。