
端侧模型能做什么?一份真实的能力边界清单
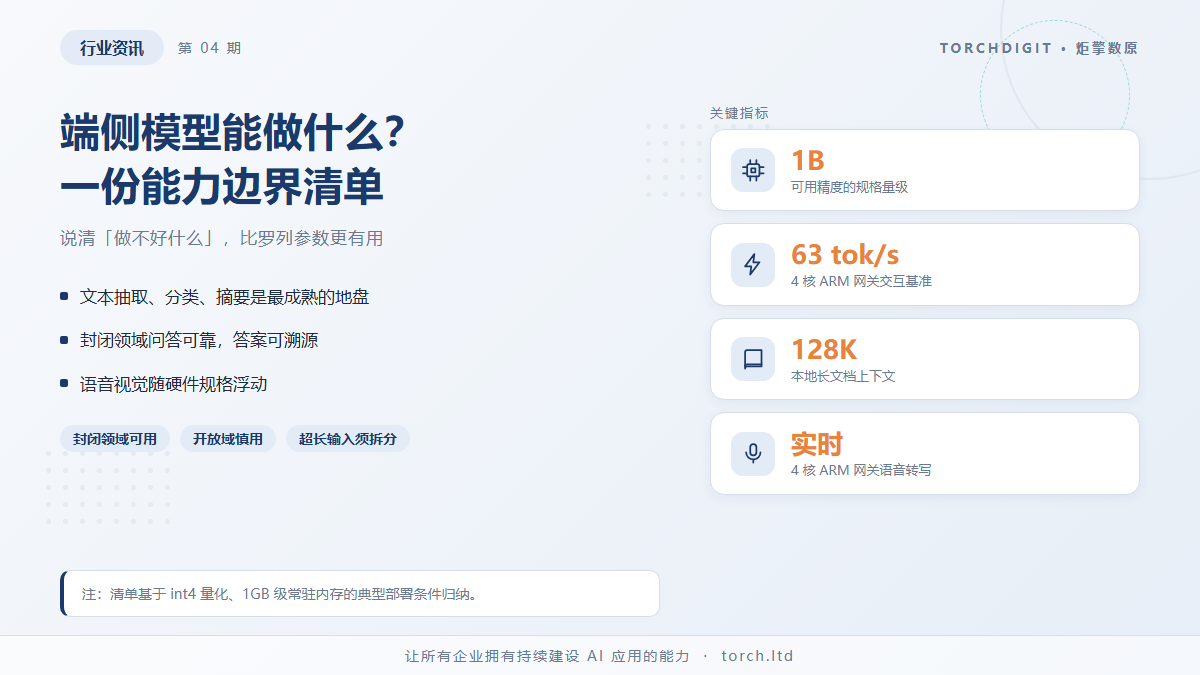
谈端侧模型,说「能做什么」容易,说「做不好什么」更有用。一份不回避短板的能力清单,比一组漂亮的参数更能帮助企业做判断。下面按任务类型逐项过一遍,每项都给出适用条件。
文本类:抽取、分类、摘要都可用
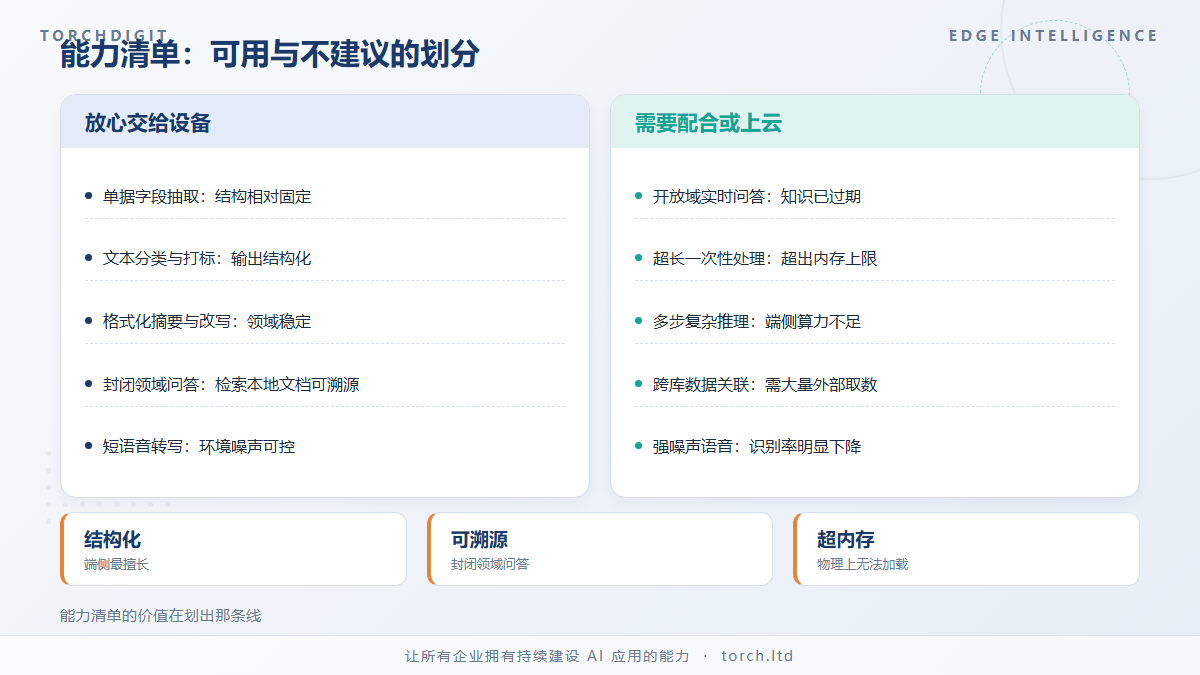
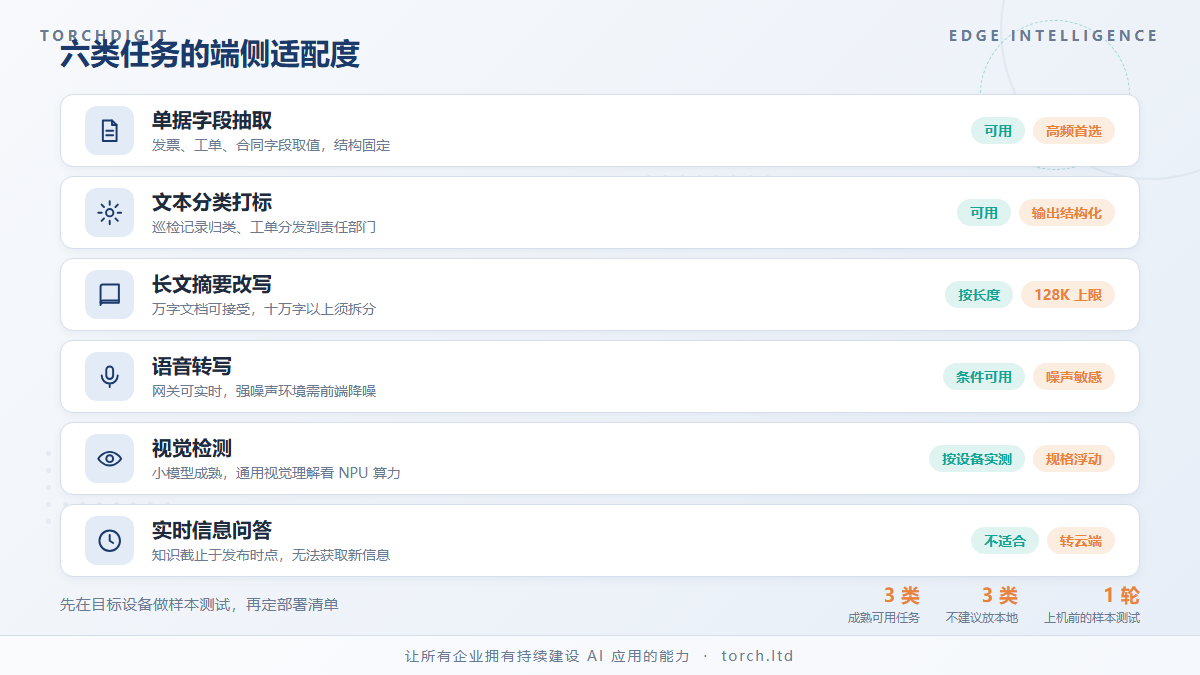
文本任务是端侧模型最成熟的地盘。单据字段抽取——从发票、工单、合同里按固定字段取值——在 1B 规格上就能做到可用精度,前提是字段结构相对固定。文本分类与打标,比如把巡检记录归到故障类型、把工单分到责任部门,属于同类任务,知识稳定、输出结构化,端侧跑起来没有压力。
摘要与改写要看长度。128K 上下文的模型在本地处理长文档可行,但速度受输入长度影响明显:万字文档的摘要可以接受,十万字以上的整册处理需要拆分或交给云端。
问答类:能答,但只答它知道的
端侧问答的边界在知识范围。模型只回答训练语料覆盖的内容,知识截止于发布时点。设备操作规程问答、产品手册问答这类「封闭领域」任务,把领域文档通过检索方式接入后,效果可靠——答案依据来自本地文档而不是模型记忆,出错时能溯源。
开放域问答是另一回事。问最新政策、问实时数据,端侧模型给不出可信答案。这类需求要么转云端,要么明确告知用户端侧回答的时效限制。
语音与视觉:随硬件规格浮动
语音转写在 4 核 ARM 网关上可以做到实时,前提是音频流连续、环境噪声可控。工业现场强噪声环境下的识别率会明显下降,需要前端降噪配合。
视觉任务——缺陷检测、安全帽识别、表计读数——取决于多模态模型规格与 NPU 算力。小型视觉模型在端侧运行成熟度高,通用视觉理解则对内存与算力要求更高,需要按设备实测选定规格。
明确不适合端侧的三类任务
清单的最后是不建议放本地的部分。第一,依赖实时外部信息的任务,模型无法获取发布之后的世界变化。第二,超大算力消耗的多步复杂推理,例如跨库数据关联分析,端侧设备跑不动也没必要跑。第三,超长上下文的一次性处理,超出设备内存上限的输入物理上无法加载。
这三类不是端侧的失败,而是分工的一部分。识别出它们,恰恰是架构设计的起点。