
为什么越来越多企业开始把 AI 放到设备本地
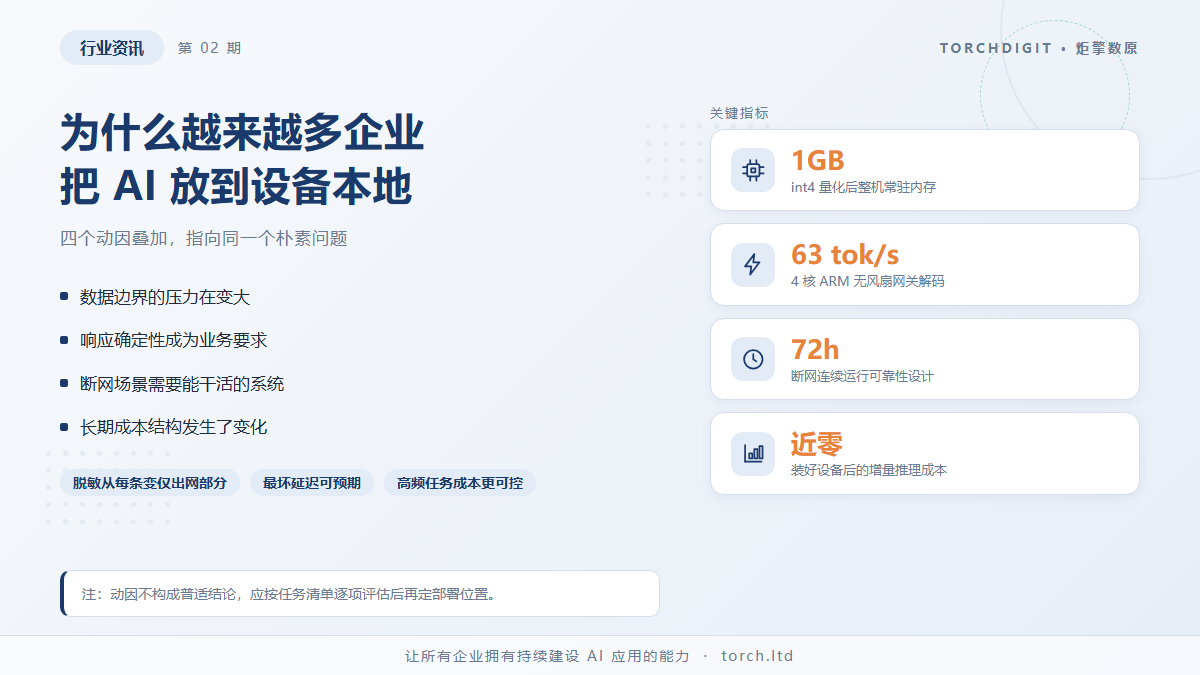
把 AI 放到设备本地,不是技术偏好,而是一笔算得过来的账。当模型的体积被量化压到 1GB 量级、当一台 4 核 ARM 网关就能跑到 63 tok/s 的解码速度,「必须上云」这个前提开始松动。越来越多企业重新审视自己的任务清单,把其中一部分搬回设备旁边。促成这件事的是四个具体的动因。
数据边界的压力在变大
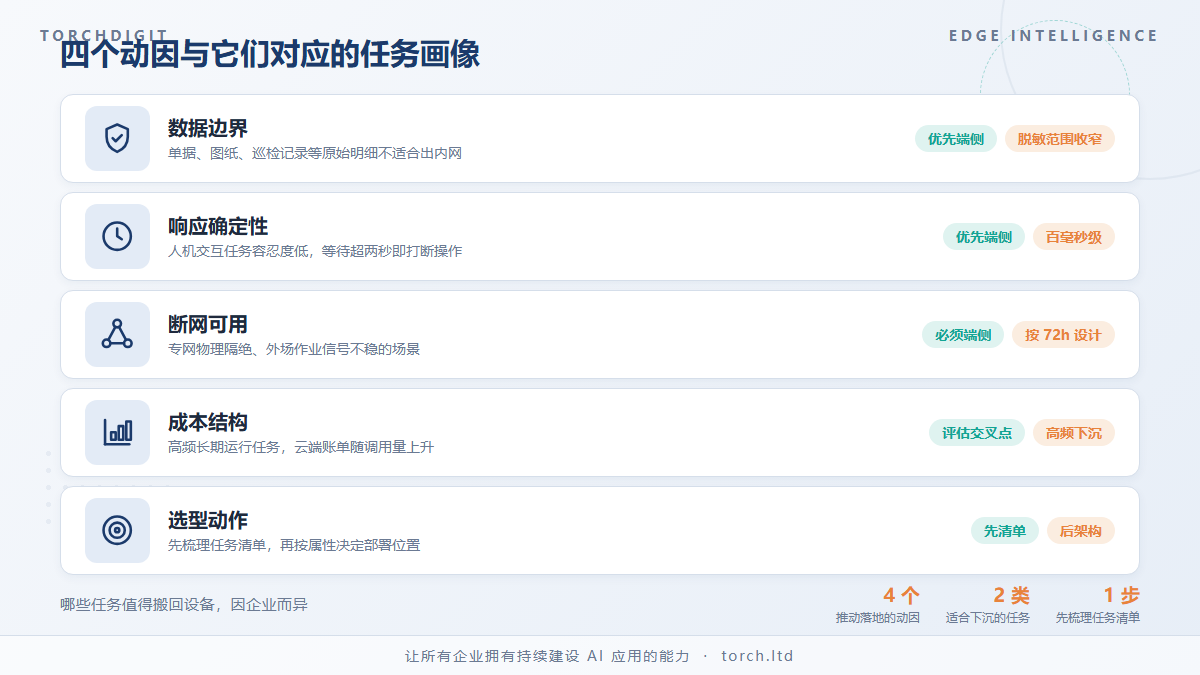
第一动因来自数据。单据、图纸、巡检记录、客户沟通纪要——企业高频产生的高价值数据,多数不适合整批送出内网。上云方案下,这类数据要么逐条脱敏后再出网,要么放弃使用 AI,两条路的成本都不低。
端侧方案把推理留在数据所在的位置。模型到设备上去,数据不出内网,脱敏环节从「每条必做」变成「仅对出网部分做」。对制造、政务、金融这类数据敏感行业,这一条往往就足以改变架构选型。
响应确定性成为业务要求
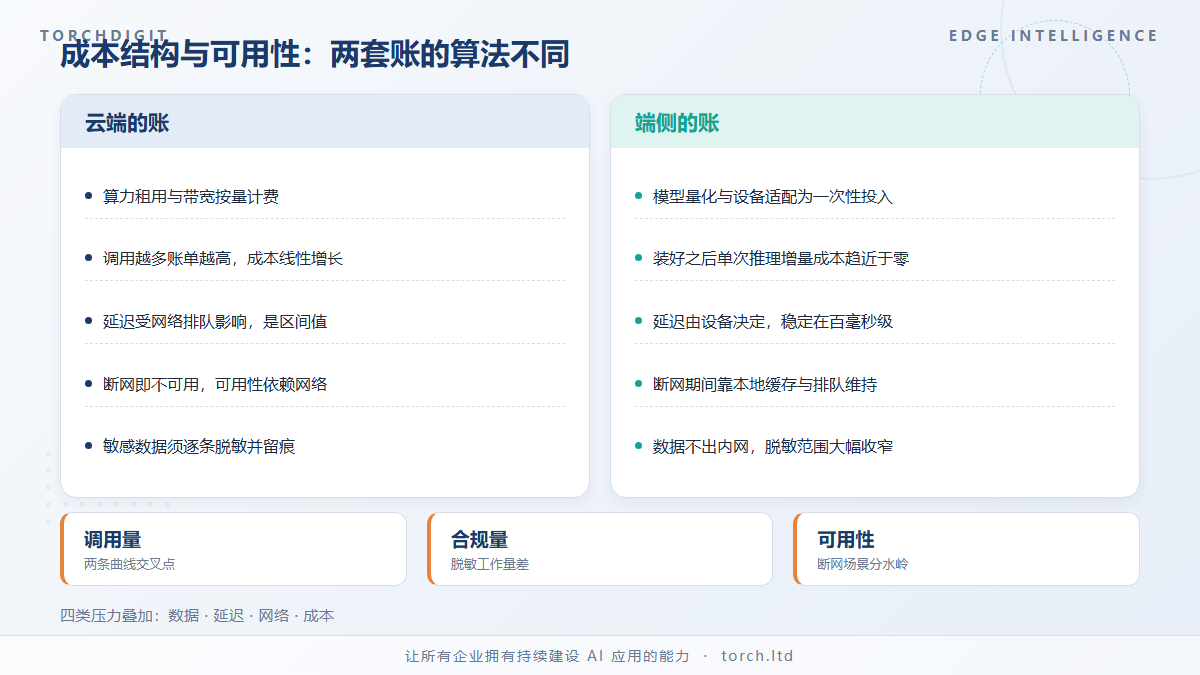
第二动因是延迟。云端推理的响应时间受网络排队与服务端负载影响,是一个区间而不是定值。设备巡检时等一次诊断结果、产线上核验一条工单,超过两秒的等待就会打断操作节奏。
端侧推理的时间由设备自己决定。模型常驻本地内存,没有网络往返,响应时间稳定在百毫秒到秒级。对交互式场景,确定性比平均速度更重要——用户能容忍每次 800 毫秒,很难容忍偶尔 8 秒。
断网场景需要能干活的系统
第三动因是网络条件。厂区专网物理隔绝、外场作业信号不稳、内网安全策略限制出网——这些场景里云端方案不是慢,是不可用。
按断网 72 小时连续运行设计的端侧部署,在断网期间依靠本地缓存与任务排队维持运转,网络恢复后再做状态同步。AI 能力从「依赖网络的服务」变成「装在设备里的部件」,可用性边界随设备本身移动。
长期成本结构发生了变化
第四动因是账。云端按量付费,成本随调用量线性增长,调用量越大,账单越高。端侧把成本前移:模型量化、设备适配、工程调试是一次性投入,之后每次推理的增量成本接近于零。
对高频、长期运行的任务,两条曲线会在某个调用量上交叉。调用量大的企业算完账后选择把高频任务下沉到端侧,把低频、重算力的任务留在云端,账单结构因此更可控。