四条模型主线的能力分工
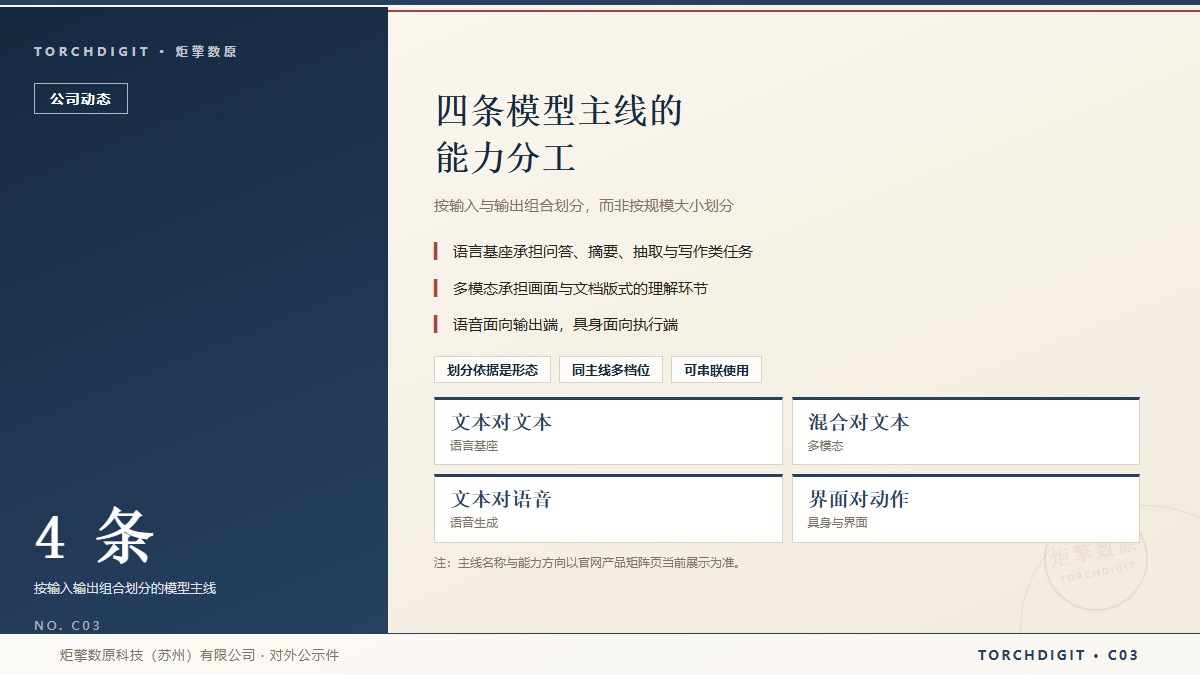
本篇说明炬擎数原四条端侧模型主线各自承担的能力方向。语言基座、多模态、语音生成、具身与界面智能体四条主线覆盖四类不同的输入与输出组合,本篇逐条说明各主线解决的问题类型,以及端侧为何把能力拆成多条主线而不是合并为一个通用模型。
四条主线对应四类输入输出
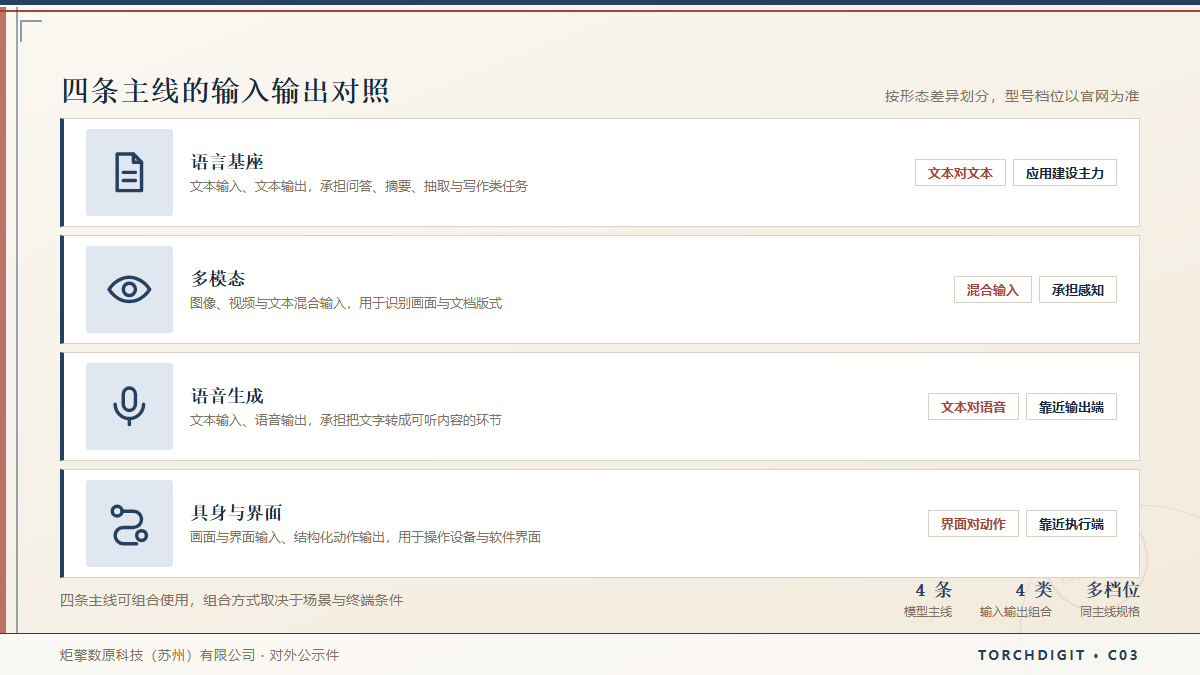
端侧的模型能力不是靠一个通用模型覆盖全部场景,而是按输入与输出的组合拆成四条主线。 语言基座主线处理文本输入与文本输出,承担问答、摘要、抽取与写作类任务,是应用建设中最常被调用的一类能力。多模态主线处理图像、视频与文本的混合输入,输出文本或语音,用于需要理解画面与文档版式的场景。语音生成主线处理文本输入与语音输出,承担语音合成类任务。具身与界面智能体主线处理画面与界面的输入,输出结构化动作,用于需要操作设备或软件界面的场景。 四条主线的划分依据是输入形态与输出形态的差异,而不是模型规模的大小。同一条主线内提供多个规格档位,供不同终端条件选择。
语言基座与多模态的分界
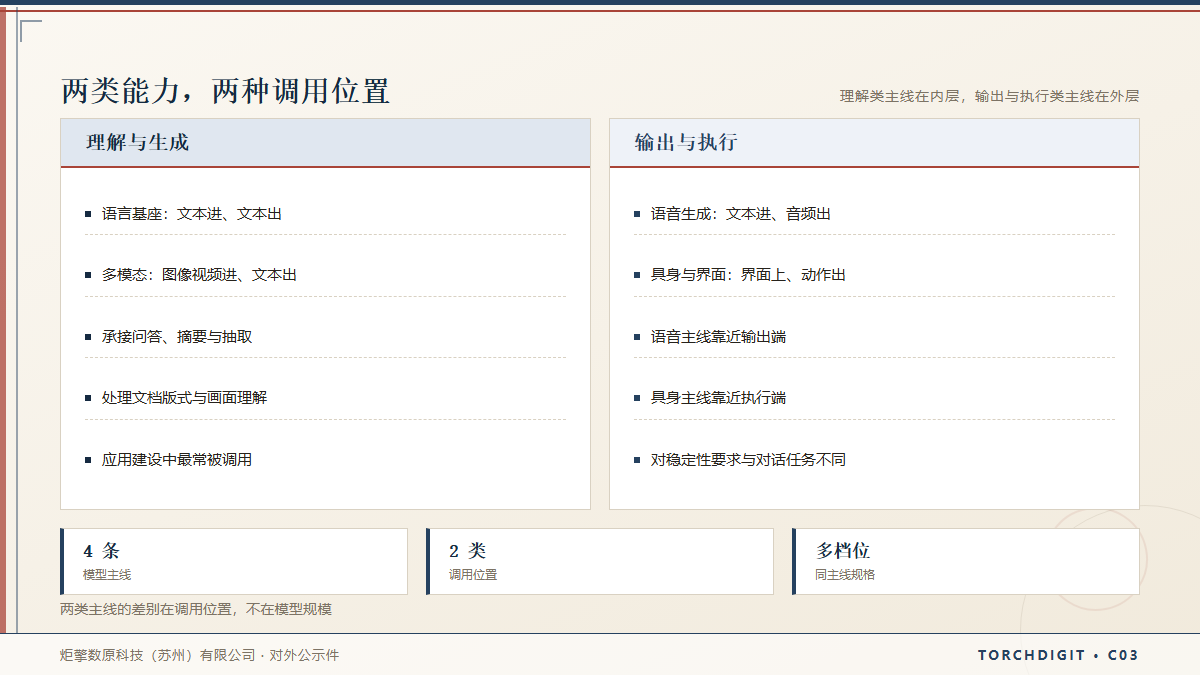
语言基座与多模态两条主线的分界,在于是否必须理解非文本信息。只需处理文字的场合,语言基座主线的规格更省资源,响应路径也更短。涉及扫描件、现场照片、界面截图或视频片段的场合,需要多模态主线承担感知环节。 两条主线在一条业务流程中常常串联使用:多模态主线先从图像或视频中提取结构化信息,语言基座主线再基于文本继续推理与生成。这两步可以运行在同一台终端上,也可以按任务切分。官网把两条主线并列展示而未合并为单一入口,与这种串联关系相符。
语音与具身两条主线的位置
语音生成主线的输出是音频,不做内容判断,承担的是把文字转成可听内容的环节。它与语言基座配合时,先由语言基座生成文本,再由语音主线合成音频。具身与界面智能体主线的输出是动作或界面操作指令,承担的是让模型影响外部设备与软件的环节。 两条主线在链路上的位置都比较靠外:一条靠输出端,一条靠执行端。它们对稳定性与响应方式的要求与对话类任务不同,因此在规格设计上也与语言基座分开。四条主线共同覆盖从感知、理解到输出与执行的完整环节。四条主线之间没有替代关系,一条主线的规格变化不会自动带来另一条的能力变化,具体型号与规格档位以官网产品矩阵页为准。
四条主线同时存在,也说明端侧的能力供给不是先做一个通用模型再逐步裁剪。按输入与输出形态划分之后,每条主线的规格区间与优化目标可以分别设定:语言基座侧重文本的准确与稳定,多模态侧重感知环节的完整,语音生成侧重音频的连贯,具身与界面智能体侧重动作的可执行。分开设定的代价是选型时需要多确认一项能力方向,收益是每类任务都能落到针对该形态设计过的模型上。